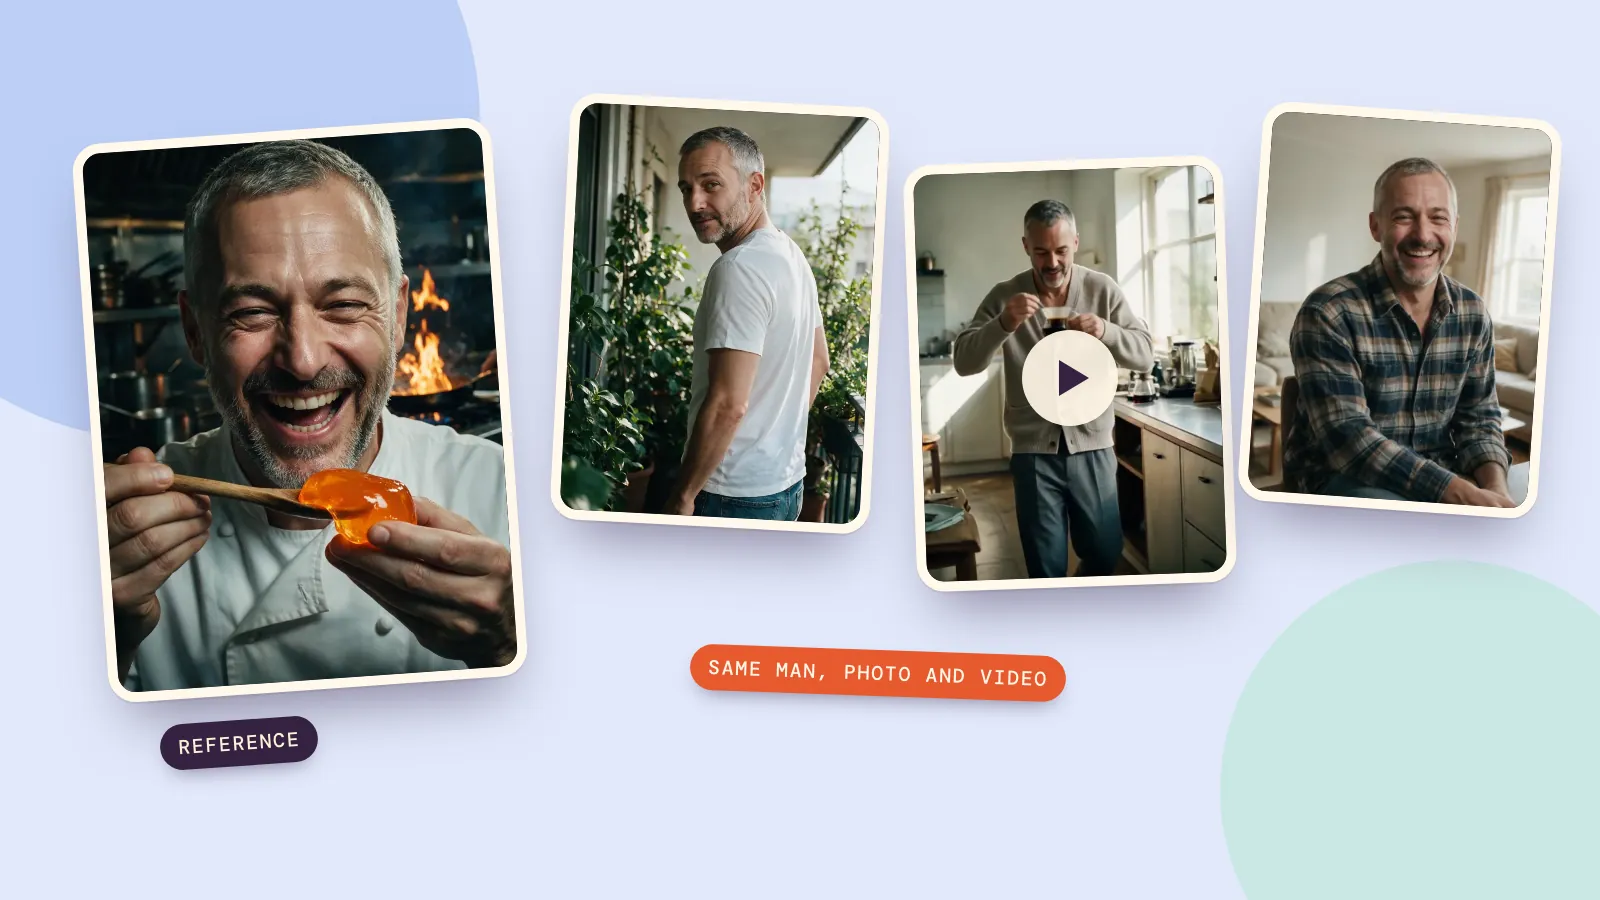
要讓 AI 角色看起來一直是同一個人,就給模型一張他的照片。只用文字描述角色,寫得再仔細,也只會得到長得像的人:描述對得上,但每次的臉都不一樣。給一張好的參考圖,再加上一句「保持臉完全一樣」的提示詞,角色就能在整組照片裡保持一致,也能延續到影片。
以下是實際結果的對照:先用一段仔細的文字描述生成三張圖,再用一張參考人像做出六張照片和一段影片。每組提示詞都附上,也標出每一步花了多少。
為什麼只描述人物不夠
我們寫了一段很詳細的男士描述,用 Seedream 5.0 Pro 生成三張圖,只換地點:
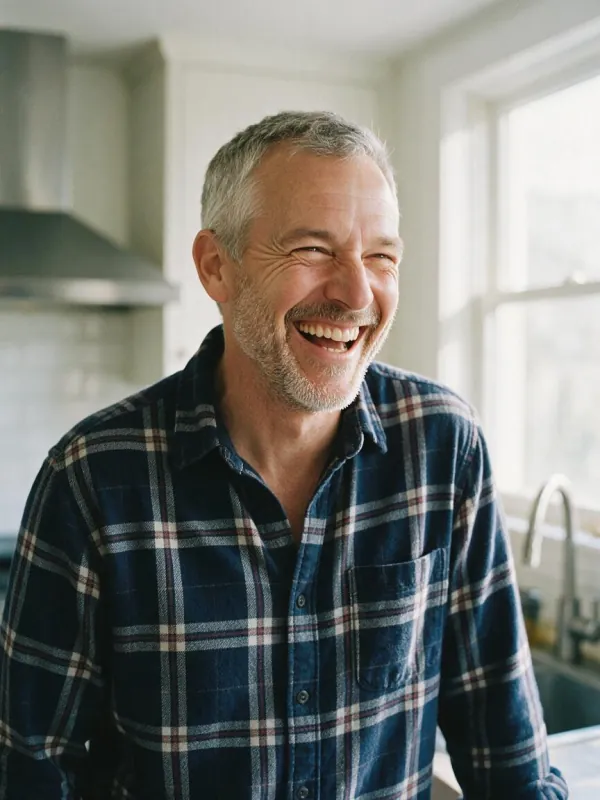
Candid photo of a man in his early fifties with short grey hair, a short grey beard and laugh lines, wearing a navy plaid flannel shirt, laughing in a bright kitchen with morning light. Natural, realistic editorial photo, 35mm film look. The person is a fictional adult.
廚房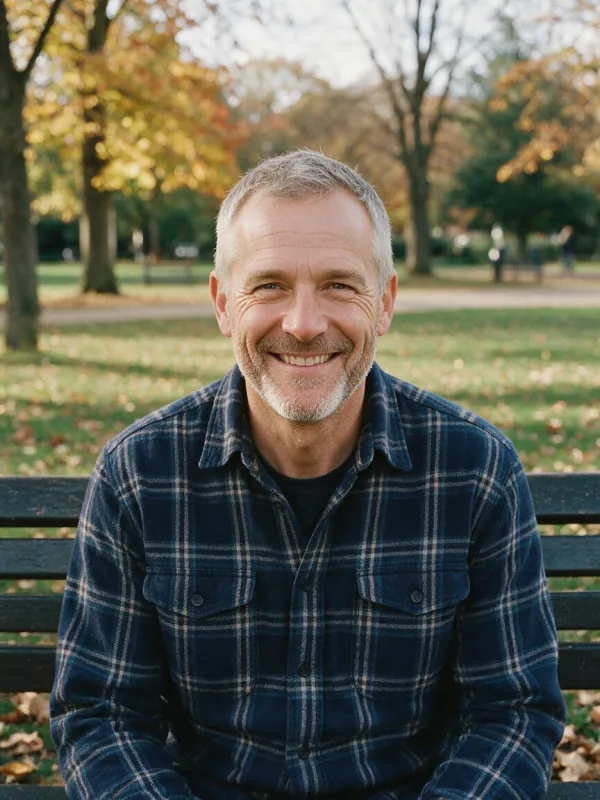 公園長椅
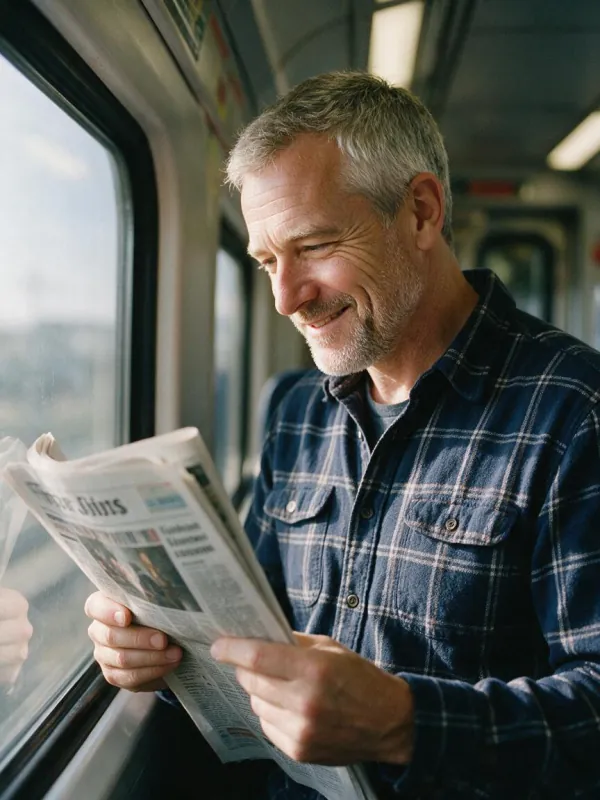 火車
每張圖都符合文字,但沒有一張是同一個人。描述只能把人縮小到一種類型;「五十出頭、短灰髮、短灰鬍」符合的臉有成千上萬張。模型每次挑一張新的,再多加形容詞也修不好這一點。
解法:每張圖都從同一張參考圖開始
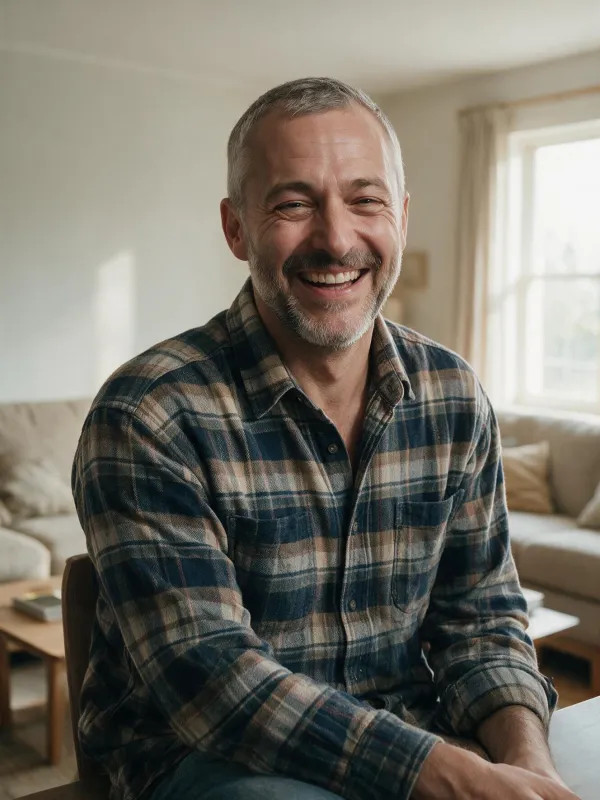
先做出(或上傳)一張清楚的肖像,之後每張新圖都用圖片編輯模型,把這張肖像當參考圖附上來生成。這是 Theo,我們在 AI 網紅頁面 建立的虛構廚師:
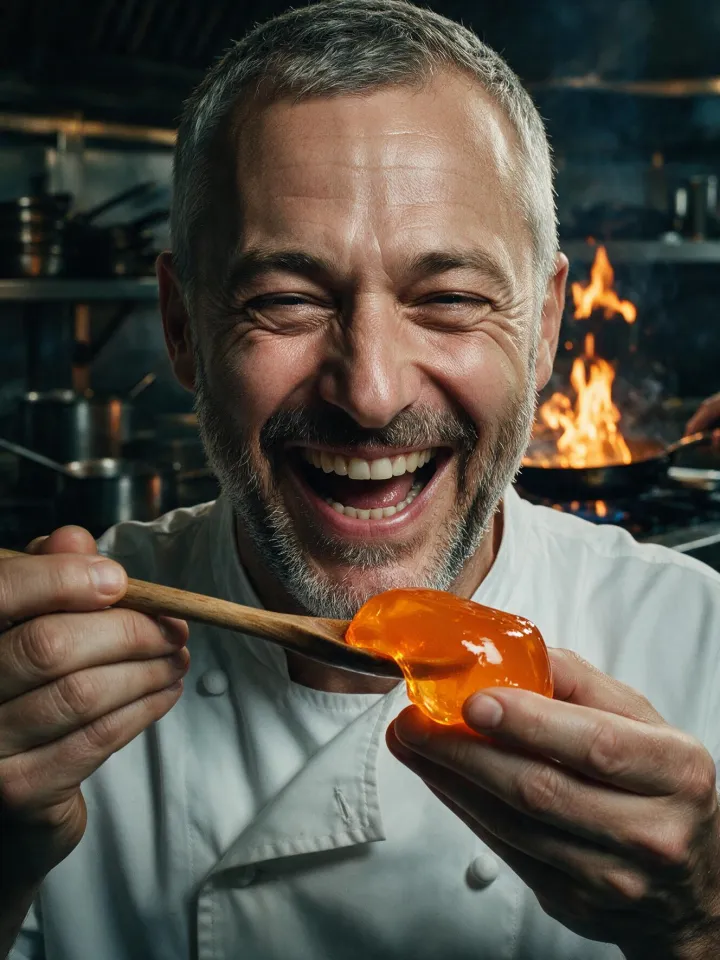
從這張肖像出發,角色套圖 頁面做出六張新的「居家」主題照片,每張的房間、服裝、取景和姿勢都不同:
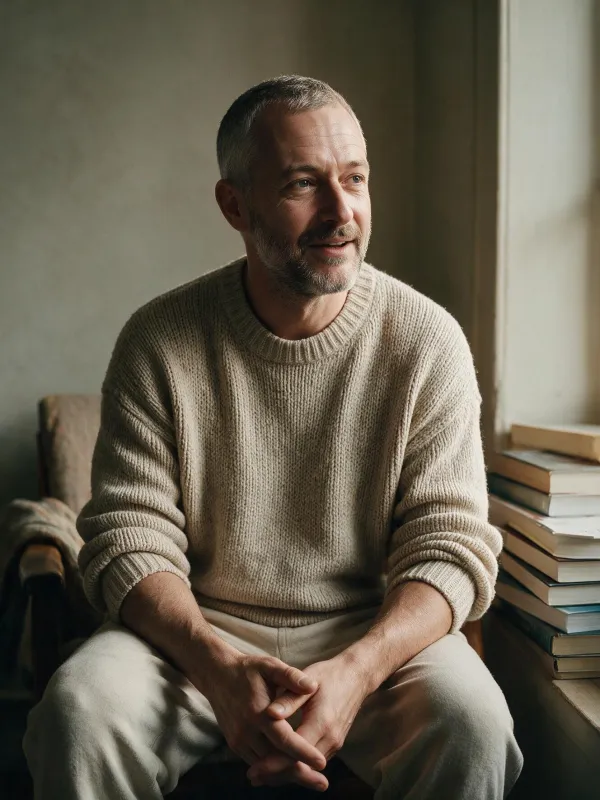 閱讀角落
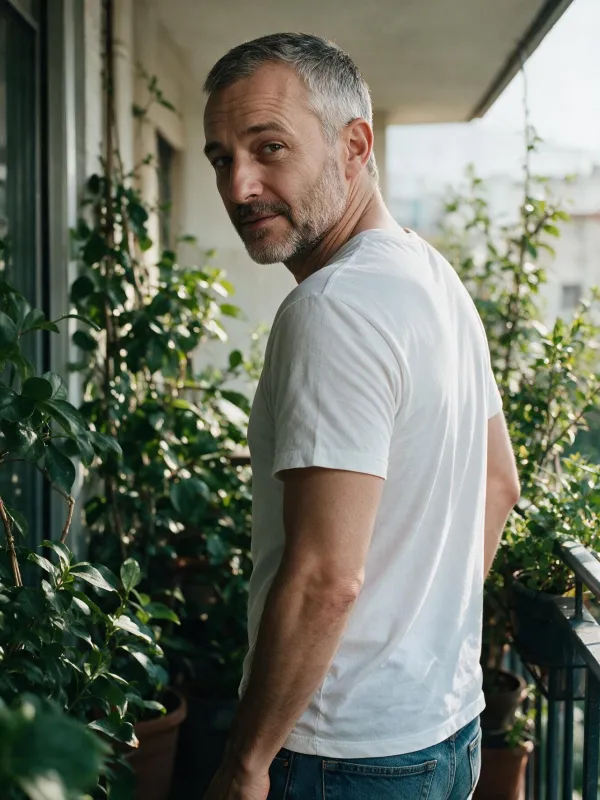 陽台
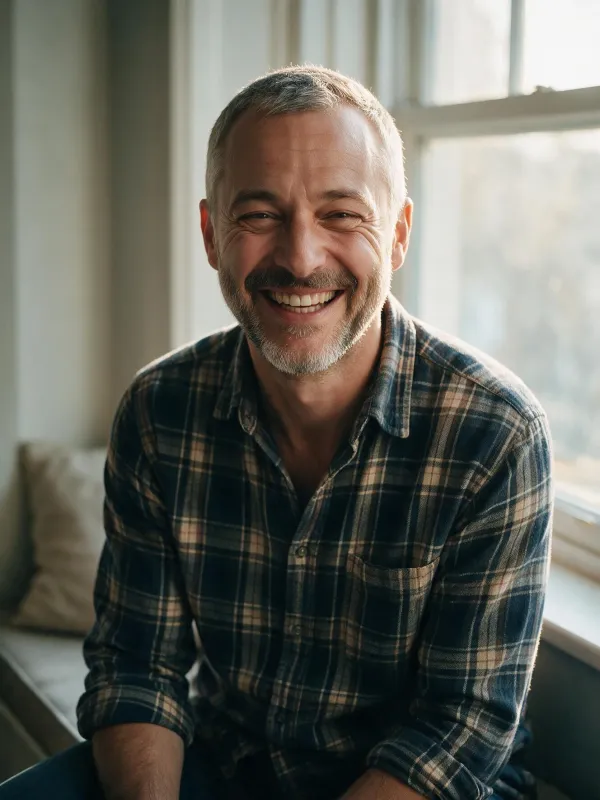 窗邊座椅
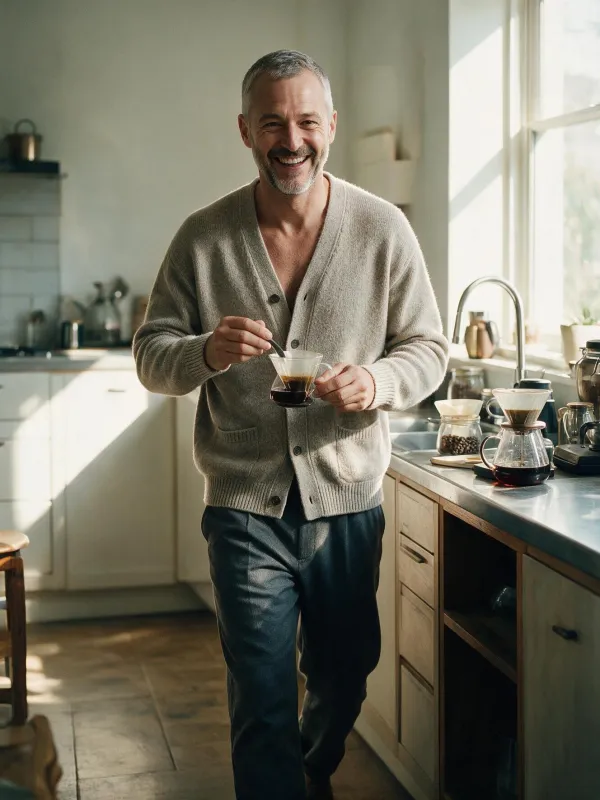 廚房
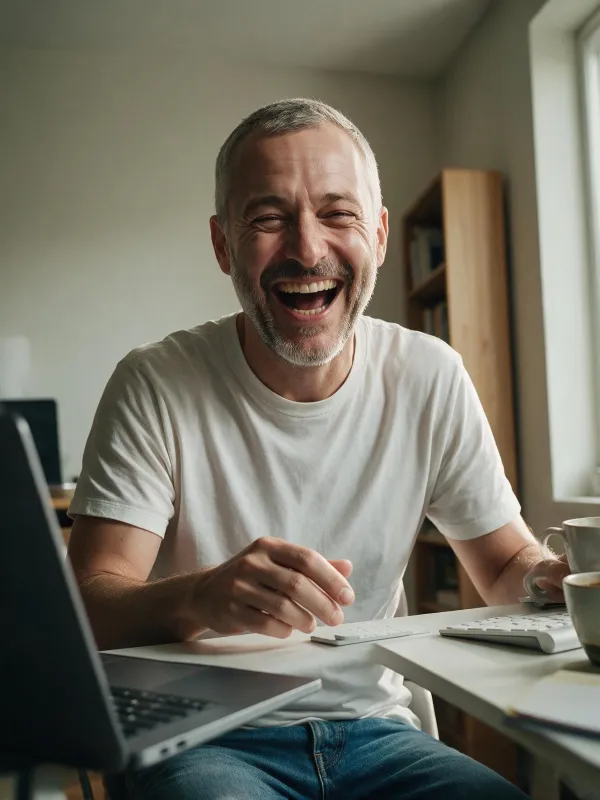 家庭辦公室
 客廳
每張照片都是帶著肖像做的一次編輯。以下是廚房那張的提示詞:
The same character as in the reference image, with exactly the same face, hair and identity. A full-length fashion photo of them walking toward the camera, wearing a relaxed cardigan, in a sunny kitchen making coffee. Natural, realistic editorial photo with strong styling and beautiful light. The person is an adult and stays fully clothed.
這組六張在 1K 下的成本是 216 點數,而角色套圖頁面會替你寫好這些提示詞:選一個主題,再選 4、8 或 12 張。
好的參考照片長什麼樣
參考圖決定了其他一切能不能守住。最好的參考圖具備:
- 臉部清楚,正面或微斜。 兩眼都看得到,不戴太陽眼鏡,嘴巴沒有被遮住。
- 光線均勻。 臉上的硬陰影會被當成臉的一部分照著複製。
- 只有一個人。 在合照裡,模型可能會把別人的特徵借給角色。
- 你想保留的細節。 如果角色一直戴眼鏡、有疤或刺青,要確保參考圖裡看得到。
- 臉要夠大。 臉應該佔畫面的一大部分。大遠景裡的小臉,給模型可以複製的東西太少。
你自己的照片也一樣。上傳作為參考圖,就能做出一組屬於你自己的套圖。
寫提示詞時,讓臉保持不變
- 先鎖住身份。 開頭寫上 "The same character as in the reference image, with exactly the same face, hair and identity.",放在場景和服裝之前。
- 每張只改一兩樣東西。 換場景和服裝,或換取景和姿勢。一次全部改,臉最容易走樣。
- 永遠回到原圖。 每張新圖都從第一張參考圖生成,不要從上一張結果再生成。複製的複製,每一代都會漂移一點。
- 依工作選模型。 在 PopNow 上,Seedream 5.0 Pro 是做套圖最全能的選擇;要求最像的時候,試試 Nano Banana 2.1。
如果你是從圖片或影片頁面生成,在提示詞框裡輸入 @,就能把已儲存的角色拉進請求,不必再上傳一次參考圖。
把同一個角色帶進影片
影片通常是角色最容易崩的地方,因為模型要在一百多個影格裡保持臉不變,而不是只有一張。可靠的做法還是同一個思路:從已經有正確臉的照片開始生成影片。我們拿上面套圖裡的廚房照,用 MiniMax H3 讓它動起來:
He walks toward the camera holding the coffee cup, takes a sip and laughs at something off-camera while the camera slowly pulls back. Soft kitchen ambience, a spoon clinking.
這段影片花了 185 點數,不到一分鐘。較長的場景可以用不同的套圖照片做幾段,再剪接在一起;或用 影片生成器 的參考模式,有些模型可以同時接受同一個人的多張照片。我們的 讓 AI 影片變長的方法 一文說明了延長和接合片段的做法。
常見問題
怎麼讓 AI 圖片裡的臉保持一樣?
用參考圖取代文字描述。先生成或上傳一張清楚的肖像,之後每張新圖都用編輯模型從它出發,提示詞開頭寫上 "the same character as in the reference image, with exactly the same face, hair and identity"。
哪個 AI 最適合做一致的角色?
能從參考圖編輯的模型最能保住臉。在我們的測試中,Seedream 5.0 Pro 在六張的套圖裡保住了臉;要求最像的時候,可以選 Nano Banana 2.1。只靠文字生成的話,任何模型都做不到。
能用我自己的照片做一致的角色嗎?
可以。在角色套圖頁面上傳你自己的照片作為參考圖,選一個主題即可。請只使用你自己的照片,或已經同意的人的照片。
這個方法適用於卡通和動漫角色嗎?
適用。同一套方法也能用,只是提示詞要求保持完全相同的畫風,而不是寫實照片。動漫方面,動漫頁面 有專為此設計的「同一角色」模式。
一組一致的角色套圖要花多少?
在 PopNow,用 Seedream 5.0 Pro 做一組六張 1K 照片是 216 點數;從其中一張用 MiniMax H3 以 768p 做 5 秒影片是 185 點數。生成前都會先顯示價格。