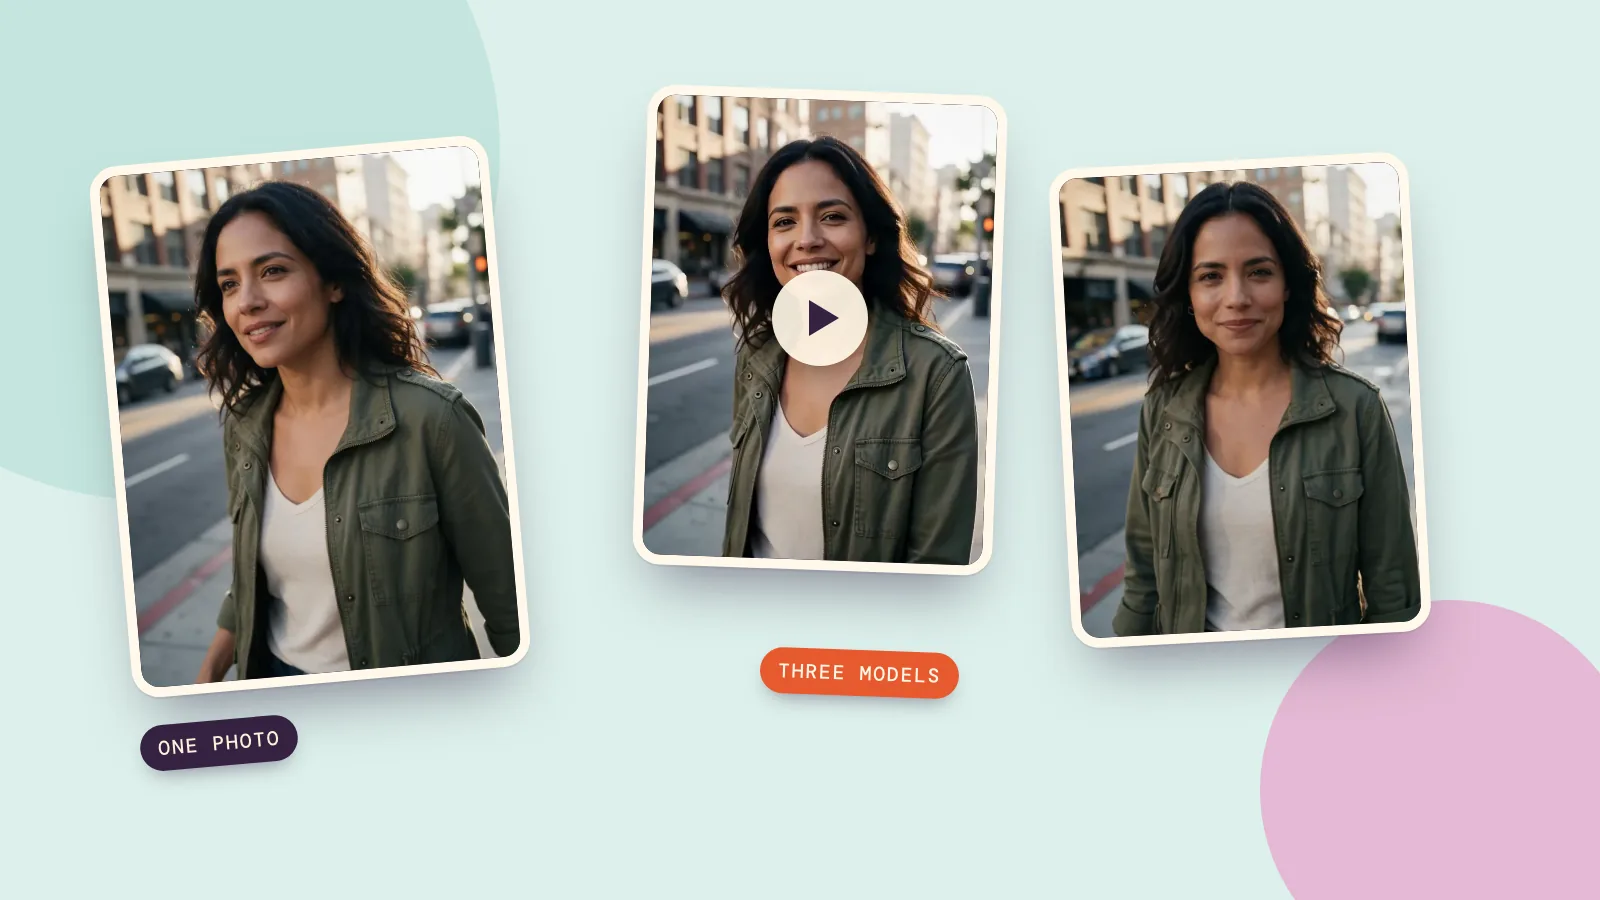
要用 AI 把照片變成影片,打開圖片轉影片工具,把圖片上傳為第一個畫面,寫一句話描述要動的部分,選一個影片模型再按下生成。大約一分鐘後,你會得到一段 5 秒的影片,並且從你的照片開始。
我們用同一張人像和同一句提示詞,在三個不同的影片模型上做了測試,讓你看到更換模型會改變什麼:動作、臉部、聲音、速度和價格。
第一步:挑一張適合動起來的照片
影片的第一個畫面就是你的照片,所以照片決定了大部分的結果。以下這類照片效果最好:
- 一個清楚的主體,在畫面中佔得大,並且臉部清楚可見。
- 清晰、光線充足。 照片中的模糊會變成影片中的模糊。
- 有移動的空間。 走路的人前方有空間可以走;貼著畫面邊緣的人則沒有。
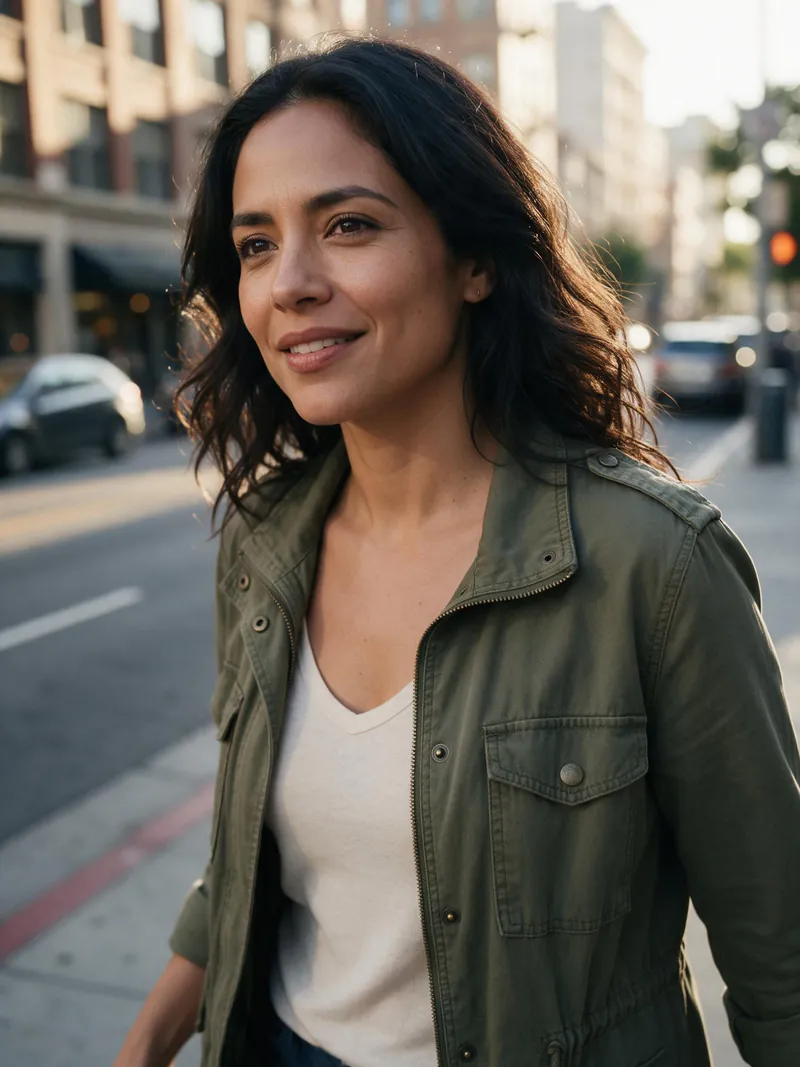
這是我們用的照片。一位女士在黃金時段的街道上,身後是模糊的城市:
第二步:用一句話描述動作
你不需要描述照片,模型已經看得到它。你要描述的是接下來會發生什麼。我們在三個模型上都用了同一句提示詞:
She turns her head toward the camera and smiles, her hair and jacket moving gently in the breeze as she walks forward slowly, the camera drifts in a little. Natural city street sound.
公式很簡單:誰做什麼、布料或頭髮怎麼動、鏡頭怎麼動。 一次只描述一個動作。「慢慢往前走並微笑」對模型來說很容易;「走路、然後跳舞、然後揮手」則是臉部開始走樣的地方。
第三步:選模型,比較三種結果
三段影片都是 5 秒,用同一張照片和同一句提示詞生成。
MiniMax H3
她轉身、微笑並朝鏡頭走來,頭髮和外套隨著提示詞的描述擺動。配樂跟隨提示詞中「自然的城市街道聲」的描述。費用:185 點數。
Kling 3.0
Kling 呈現出最平靜、最自然的表情:小小一抹放鬆的微笑,而不是大大的笑容,三者中皮膚的細節也最清晰。預設關閉聲音,所以這段是無聲的。費用:336 點數。
Seedance 2.0 Fast
三者中最快、畫面最小(480p)。動作比另外兩者溫和。它適合先試五個構想,再把更多點數花在最好的那一個上。費用:225 點數。
並排比較
| MiniMax H3 | Kling 3.0 | Seedance 2.0 Fast | |
|---|---|---|---|
| 我們使用的解析度 | 768p | 720p | 480p |
| 聲音 | 有 | 預設關閉 | 有 |
| 生成時間 | 約 80 秒 | 約 130 秒 | 約 40 秒 |
| 5 秒的費用 | 185 點數 | 336 點數 | 225 點數 |
| 最適合 | 聲音和更生動的表演 | 自然的臉部 | 快速草稿 |
三段影片中,她的臉、頭髮和外套在整段影片裡都和照片很接近。這正是圖生影片模型該有的表現:讓你的照片動起來,而不是取代它。
第四步:下載、延長或套用特效
影片生成完成後就能下載。如果想要更長,可以從最後一格延長影片。如果完全不想寫提示詞,影片特效是一鍵套用的版本,例如氣球升空、跳舞或擁抱。只要加入一張照片即可。
有效的提示詞範例
- 走路。 "She walks slowly toward the camera, the wind moves her hair."
- 人像。 "He looks up, smiles and nods slightly. The camera pushes in slowly."
- 寵物。 "The dog shakes its head and wags its tail, the camera stays still."
- 商品。 "The camera slowly orbits the mug, steam rises from the cup."
- 風景。 "Clouds drift across the sky, ripples spread across the lake."
常見問題
- 臉變了。 把提示詞縮短成一個動作,並在第二個模型上試同一張照片。
- 幾乎沒有動。 加上鏡頭運動(「慢慢推近」)和身體或布料的動作(「她的圍巾輕輕飄動」)。
- 結尾看起來怪怪的。 要求 5 秒,不要 10 秒;大多數模型在前五秒最穩定。
- 想要聲音。 模型提供時就開啟音訊,並把聲音寫進提示詞(「雨打在窗戶上的聲音」)。
如果同一個角色要出現在很多段影片裡,請先在角色中做好這個角色,然後每次都把它當作起始照片。
常見問題
怎麼用 AI 把照片變成影片?
在圖生影片工具中把照片上傳為第一個畫面,寫一句話描述動作,選擇模型後生成。依模型不同,結果是 3 到 15 秒的影片片段。
可以免費把圖片變成影片嗎?
在 PopNow 上不是免費的,但用快速模型做一次簡短測試,只需要少量點數。你按片段付費,沒有訂閱,生成前會先顯示價格。
哪一種 AI 最適合把照片變成影片?
取決於你的需求。在我們的測試中,MiniMax H3 的表演和聲音最生動,Kling 3.0 的臉最自然,而 Seedance 2.0 Fast 最快也最便宜。可以拿你的照片在兩個模型上試試。
影片可以多長?
每個模型各有上限,一般每段 5 到 15 秒。想要更長,可以從最後一格延長,或把幾段接起來。
影片會保留人物的臉嗎?
在我們的三段影片中會。使用清晰、臉部明確的照片,只要求一個動作,並避免大幅度的動作,相似度最好。