提供:Sand.ai動画
daVinci-MagiHuman
セリフを「」で囲めば、画面の人物がそのセリフを話します
- 最大1080p
- 5〜10秒
120クレジットから (5秒の動画)≈ $0.12· 動画を作成
実際に使ってみると
daVinci-MagiHuman は、Sand.ai と SII-GAIR によるオープンモデルで、映像と声を同時に生成します。話させたいセリフを「」で囲めば、画面の人物がそれを話します。プロンプトまたは開始写真から、5〜10秒のクリップを256p・720p・1080pで、16:9 または 9:16 で作ります。
向いている用途
- カメラに向かって1つのセリフを話すプレゼンター
- 解説や広告に使う、短い対話の場面
- 自分で書いたセリフを話す、ポートレート写真のアニメーション化
daVinci-MagiHumanの実際の作例
ここにある画像と動画はすべてdaVinci-MagiHumanで生成したものです。「同じものを作る」を押すと、同じプロンプトと設定でスタジオが開きます。
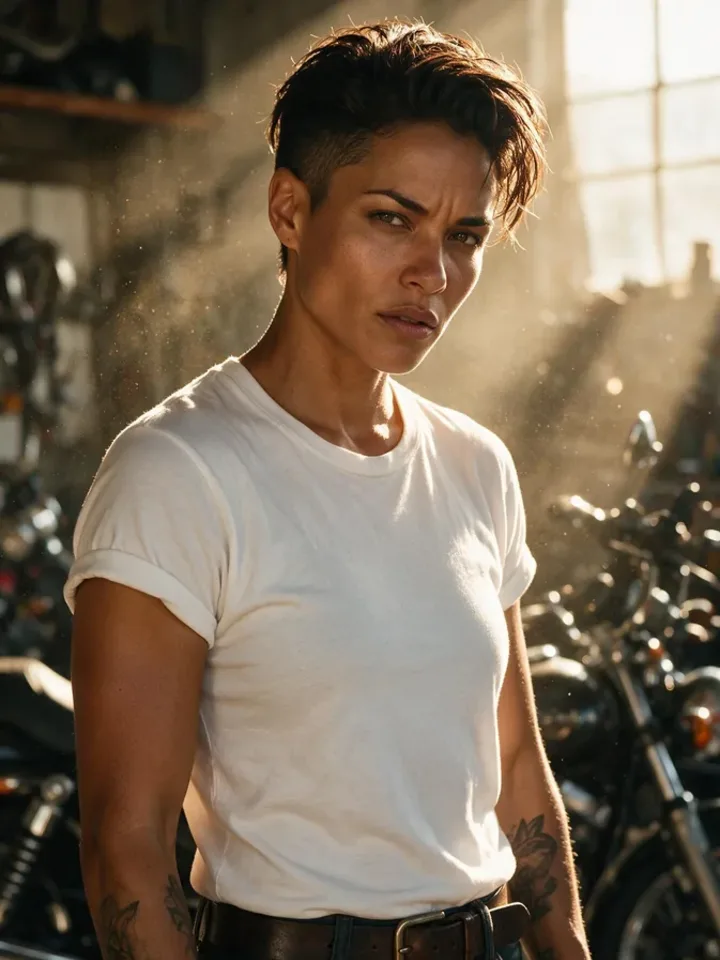 元画像
自分の画像を用意してください
daVinci-MagiHumanでできること
どのモードもdaVinci-MagiHumanを選んだ状態でスタジオが開きます。料金は生成前に表示されます。
daVinci-MagiHumanのプロンプトのコツ
- 「」で囲んだセリフは、選んだクリップの長さの中で無理なく言える短さにしてください。
- 顔を同じに保ちたいときは写真から始めてください。文章だけだと毎回別の人物が生まれます。
- 256pで下書きしてタイミングを確認し、720pまたは1080pで仕上げましょう。
知っておきたい設定
そのほかの設定は適切な初期値になっているので、プロンプトを書けばすぐ生成できます。
resolution256p · 720p · 1080p- 出力サイズ。大きいほど鮮明で、料金も上がります。
aspect_ratio16:9 · 9:16- 画面の形:横長、正方形、縦長。
duration_seconds5–10s- 動画の長さ。1秒ごとに課金されます。
image_url- 出発点になる画像。
seed0–2147483647- 同じ数字を使えば、同じ結果を再現できます。
ほかのモデルとの比較
同じ用途でも、得意なことと料金が違います。
MiniMax H3 は、音声つきでより長いクリップも作れる万能の動画モデルです。場面がほとんど人物の話す姿なら daVinci-MagiHuman を選んでください。


daVinci-MagiHumanについてよくある質問
daVinci-MagiHumanの料金は?
PopNowでは、daVinci-MagiHumanは最安で120クレジット(5秒の動画)、約$0.12です。サイズが大きいほど高くなります:256p 120 · 720p 240 · 1080p 360。支払いはクレジット(1クレジット=0.001ドル)で、正確な料金は生成ボタンに事前に表示されます。失敗した生成は自動で返却されます。
daVinci-MagiHumanで何ができる?
PopNowでは、daVinci-MagiHumanは次のモードで使えます:動画を作成、画像から動画。スタジオでモードを選び、プロンプトかファイルを入れるだけです。
daVinci-MagiHumanの動画の長さと画質は?
1本5–10s、最大1080p。
daVinci-MagiHumanのプロンプトはどう書く?
「」で囲んだセリフは、選んだクリップの長さの中で無理なく言える短さにしてください。 顔を同じに保ちたいときは写真から始めてください。文章だけだと毎回別の人物が生まれます。 256pで下書きしてタイミングを確認し、720pまたは1080pで仕上げましょう。
daVinci-MagiHumanとMiniMax H3、どちらを選ぶ?
MiniMax H3 は、音声つきでより長いクリップも作れる万能の動画モデルです。場面がほとんど人物の話す姿なら daVinci-MagiHuman を選んでください。
daVinci-MagiHumanを使うのに何かインストールが必要?
不要です。daVinci-MagiHumanはPopNowのブラウザ上で動きます。プロンプトを書くかファイルを追加し、設定を選んで結果をダウンロードするだけ。登録すればすぐに生成できます。