照片已经决定了人物、场景和光线。把提示词留给会变化的部分和镜头的走向,小而模糊的照片先放大。做对这两点,图生视频更稳,也更省积分。
照片已经回答了视频模型最需要去猜的大部分问题:画面里是谁、穿什么、站在哪里、光怎么打、画面是什么风格。把这些再写一遍没有帮助。最好的情况是白费字数;更糟的是,模型会去对照你的描述而不是照片,开头几帧就开始走样。
步骤 1:先看照片已经定下了什么
花十秒看看照片,列出已经确定的内容:人物和姿势、场景、时间和光线、颜色和风格。这些都不必写进提示词。
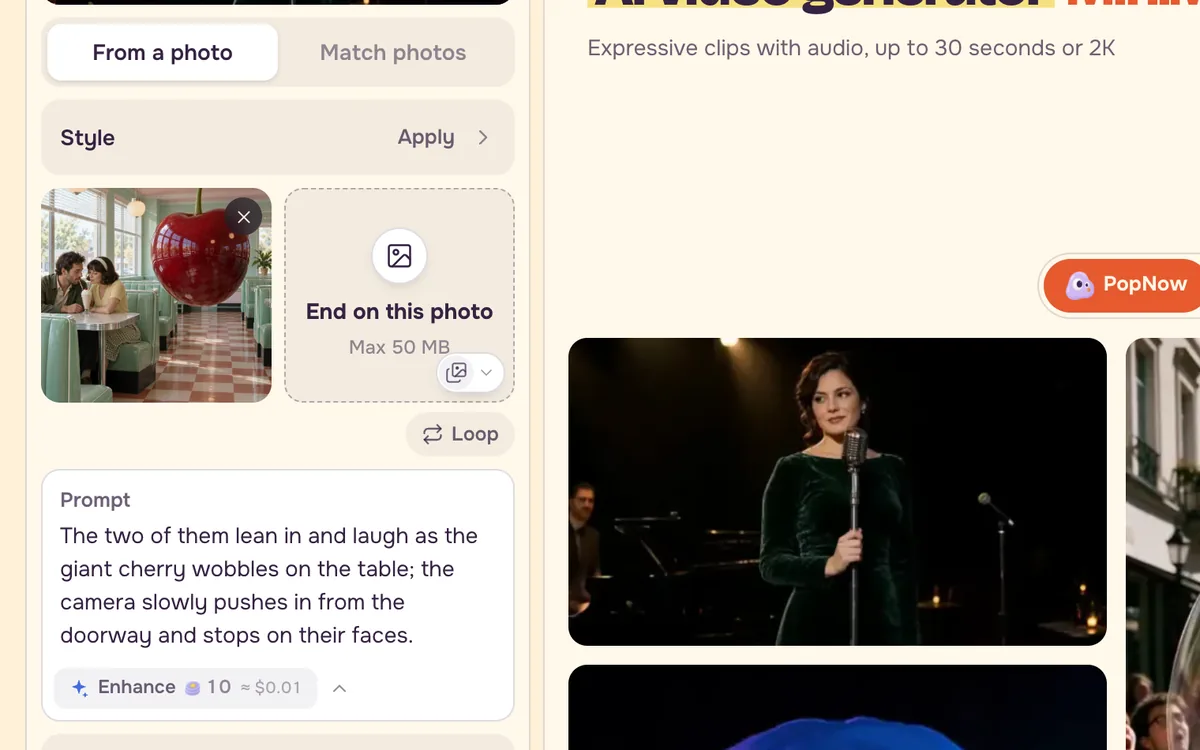
步骤 2:写下变化和镜头
静态图无法呈现时间。你的提示词有两项任务:说明片段里发生了什么,以及镜头怎么移动。照片不错的话,每项写一句通常就够了。
She lifts the mug, blows across it once and smiles toward the window as steam curls up; the camera eases in from a medium shot to a close-up and stops on her face.
写动作时,要写出起点和终点(「转身、挥手,然后放下手」),而不是状态(「很开心」)。也要写出镜头最后停在哪里,让这次移动有去处。
步骤 3:只引入画面里已有的东西
当提示词提到照片里没有的人或物,许多模型会为了腾出位置而切换到新场景。把新元素去掉,或者写清楚它们如何进入画面:「一名骑车人从左边缘骑入,经过她身后」。
步骤 4:小或模糊的照片先放大
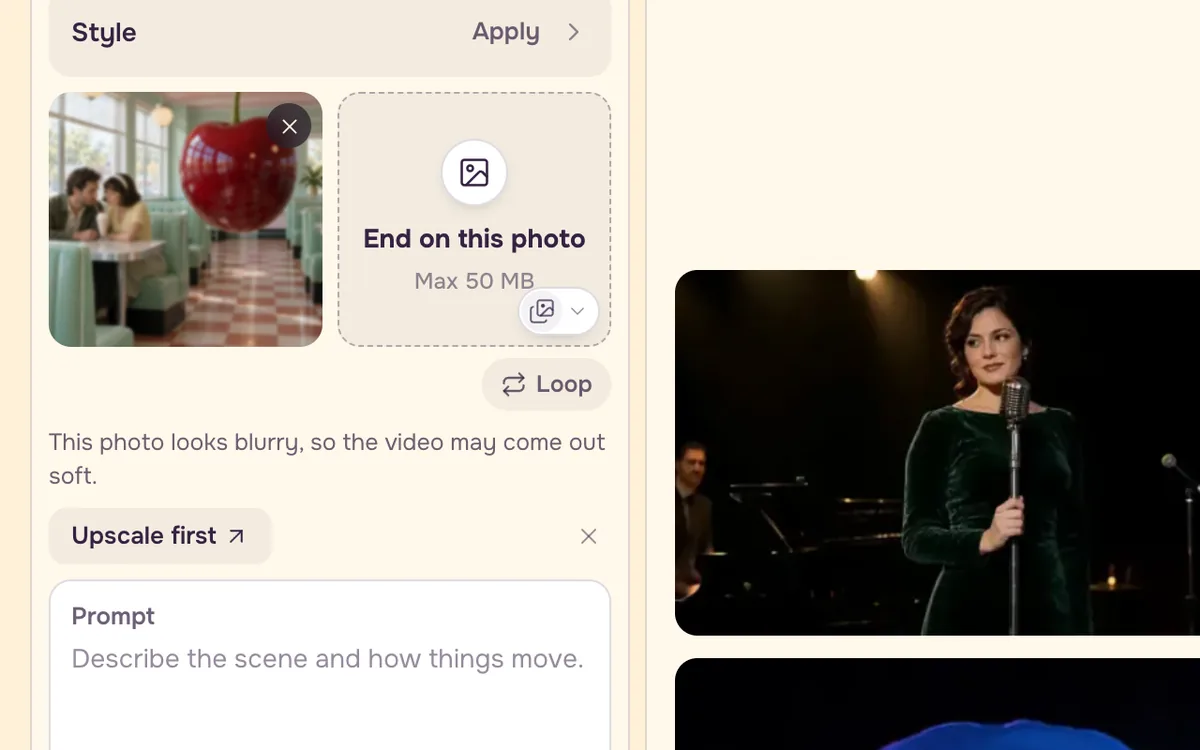
视频模型会把开头那一帧拉伸到输出尺寸,所以小的或柔和的照片会变成柔和的片段。当你添加的起始照片明显太小或太模糊时,上传位下方会出现一行提示和 先放大。它会带你到 放大 页面,清晰的版本准备好后,会直接作为起始帧回到你的视频中,你的提示词和设置保持不变。检查在浏览器中进行,只有照片明显太小或太模糊时才会出现;你可以忽略它直接生成。
前后对比
| 不要这样写 | 改为这样写 |
|---|---|
| A woman with red hair in a cream sweater sits at a wooden table in a sunny kitchen holding a mug. | She lifts the mug, blows across it once and smiles toward the window. |
| Beautiful cinematic lighting, highly detailed, sharp focus. | The camera eases in to a close-up and stops on her face. |
常见问题
为什么我的片段切换到了另一个场景?
通常是提示词提到了照片里没有的东西,或者对场景的描述与画面不一致。去掉新元素,只保留动作和镜头;如果模型仍然切换,就加上「一个连续镜头」。
图生视频的提示词应该多长?
比文生视频的提示词短。两句话通常就够:发生了什么,以及镜头怎么移动。如果模型会生成声音,再加一句说明声音。
先放大会改变我的照片吗?
默认的放大会锐化照片并补充缺失的细节。对于很模糊的照片,它可能会修饰眼睛等小细节,所以如果脸必须保持原样,请在放大页面选择 精准,再按放大。