什么是 AI 数字人?
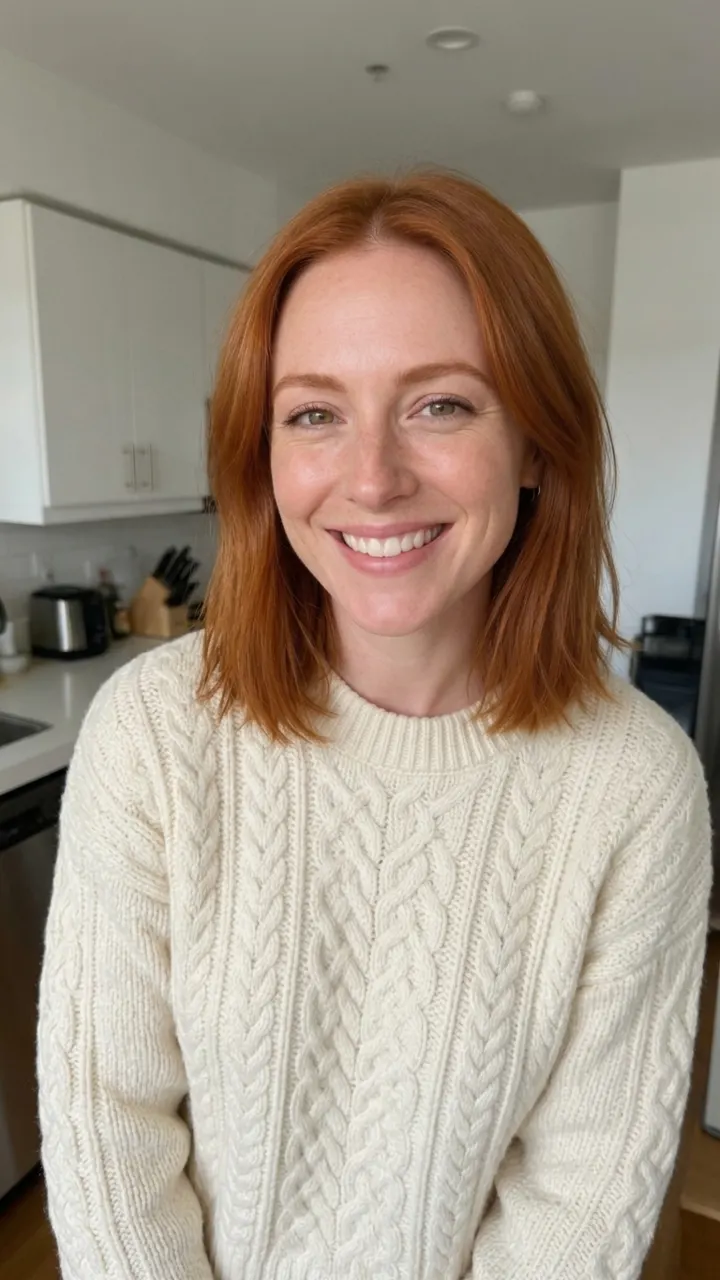
AI 数字人是由一张照片生成的、看起来像真人在说话的视频。上传人像,给它一段要说的话,脸部就会随着语音动起来:嘴唇、眼睛、轻轻点头和表情都会跟着声音变化。
声音来源由你决定。可以输入文案,从六种录音室声音中选一种朗读;也可以用你克隆的声音朗读;还可以上传录音或歌曲。视频长度与音频完全一致,从几秒到一分钟不等。
如何制作说话的照片
- 添加人像一张清晰的照片,一张脸大致朝向镜头。半身照效果最好。
- 设置声音输入文案,选择声音或你克隆的声音,或上传 3 到 60 秒的 MP3 或 WAV。
- 让它开口开始前按钮会显示完整价格。下载视频,或发送去剪辑、翻译或分享。
为什么在这里制作数字人
- 支持任何语言。 文案会按你输入的语言朗读,同一张人像可以用英语、西班牙语或日语向顾客问好。
- 使用你自己的声音。 克隆一次你的声音,之后做的每个数字人都能用它说话。
- 说话或唱歌。 上传一首歌,人像就能演唱,呼吸和表情会跟着音乐变化。
- 选择引擎。 自动模式会选择快速、实惠的模型;需要更长的视频或 1080p 画质时,可切换到高级数字人模型。
大家用它做什么
- 店铺问候 一张友好的面孔,在商品页或菜单界面上欢迎访客。
- 课程与讲解短片 同一位讲师每次都来讲解的短课。
- 生日祝福 用你的声音,让照片里的人送上生日祝福。
- 社交媒体内容 无需架设摄像机,就能做开场和结尾的说话片段。
让效果更自然的技巧
- 使用清晰、光线均匀的照片。墨镜、手挡住嘴、侧脸角度大,都会让口型更难跟上。
- 每段视频控制在一分钟以内,长文案可以拆分成多个场景。
- 标点会影响朗读节奏:逗号带来短暂停顿,感叹号让语气更有力。
- 唱歌时,上传干净的人声轨。乐器过重会让口型变得模糊。
请负责任地使用
只使用你本人的脸和声音,或已同意的人的脸和声音。请勿上传任何未满 18 岁的人的素材,也不要用结果误导他人,让人以为某人说过或做过某件事。每个请求都会经过 PopNow 的内容审核,上传的素材仅用于生成你的结果。
价格
按成片秒数计费:Talking Avatar 每秒消耗 18 积分,因此输入文案的 10 秒片段,连同声音约需 184 积分。开始前按钮总会显示总价,失败的任务会退还积分。
常见问题
可以使用任何照片吗?+
请使用你本人或已同意的人的照片,切勿使用未满 18 岁的人的照片。上传的照片在使用前需要勾选一次许可确认。
它能说哪些语言?+
输入的文案会按你书写的语言朗读,包括英语、西班牙语、法语、德语、葡萄牙语、日语、韩语和中文。上传的音频可以是任何语言。
视频最长多久?+
默认模型支持 3 到 60 秒;「更多选项」中的高级模型可接受更长的音频。
它能唱歌吗?+
可以。选择「上传音频」并添加一首歌,人像会演唱到音轨结束为止。
费用是多少?+
Talking Avatar 每秒视频消耗 18 积分,因此含声音的 10 秒片段约需 184 积分。
视频归谁所有?+
归你所有。结果会保存到你的 PopNow 资料库,只要你对照片和声音拥有相应权利,即可商用。
 示例