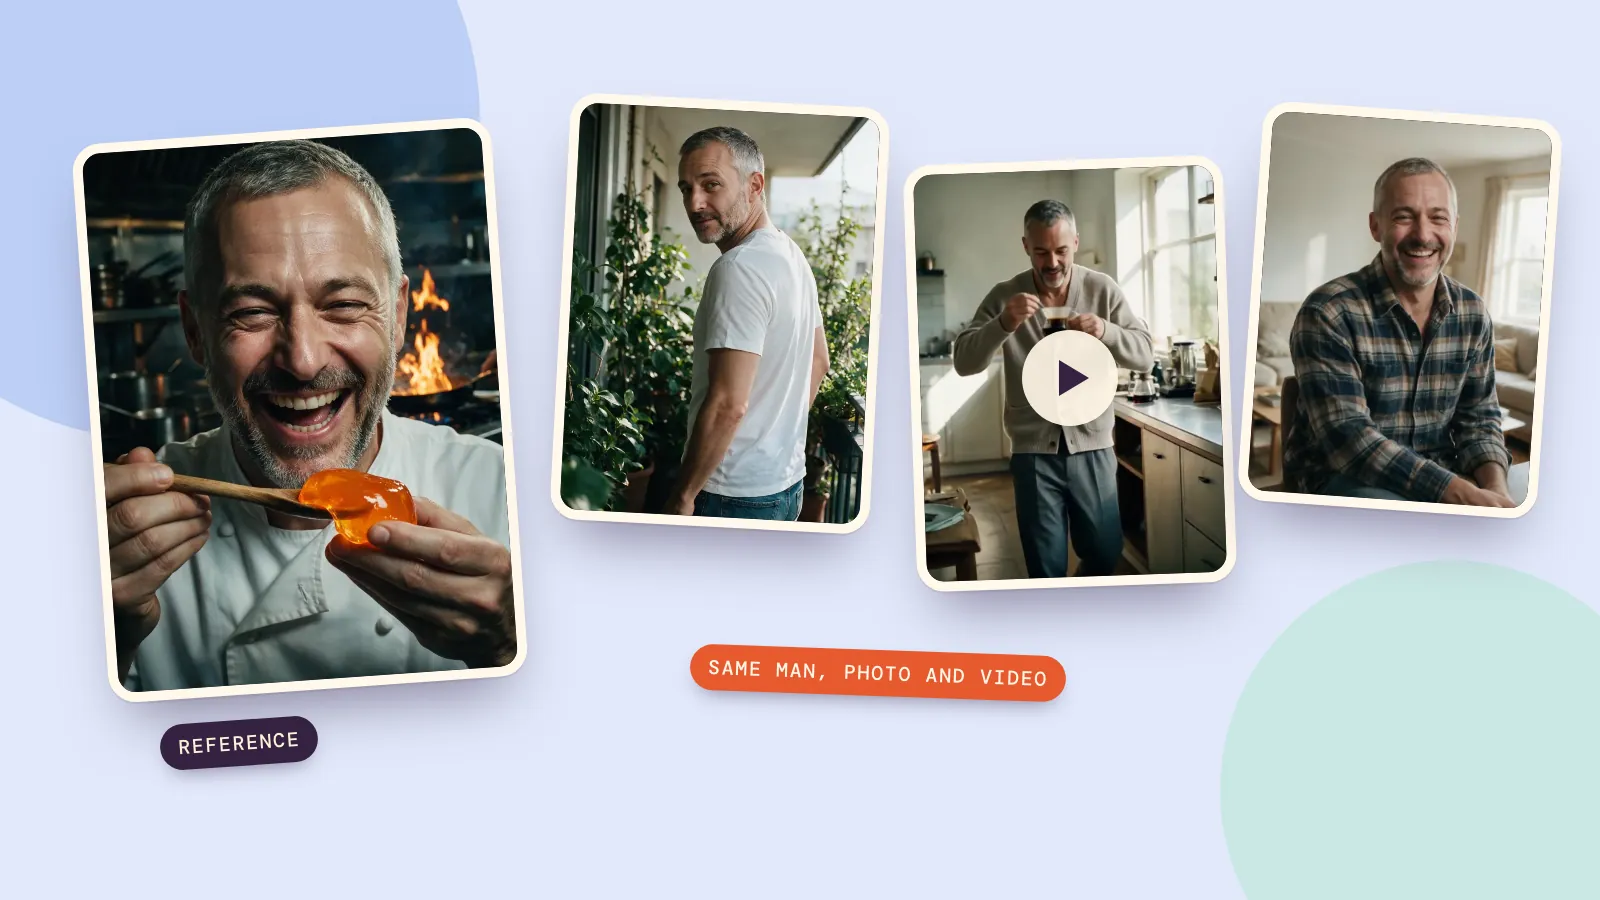
要让 AI 角色始终是同一个人,就给模型一张他的照片。只用文字描述角色,再仔细也只会得到长得像的人:符合描述,但每次的脸都不一样。一张好的参考图,加上一句「保持完全相同的脸」的提示词,才能让角色在整套照片里保持一致,并延续到视频里。
下面是真实结果的对比:先用一段仔细写的文字描述生成三张图,再用一张参考肖像做出一套六张照片和一段视频。每条提示词都附在这里,每一步花了多少也写清楚。
为什么只描述人物还不够
我们为一个男人写了一段详细的描述,只换了场景,用 Seedream 5.0 Pro 生成了三张图:
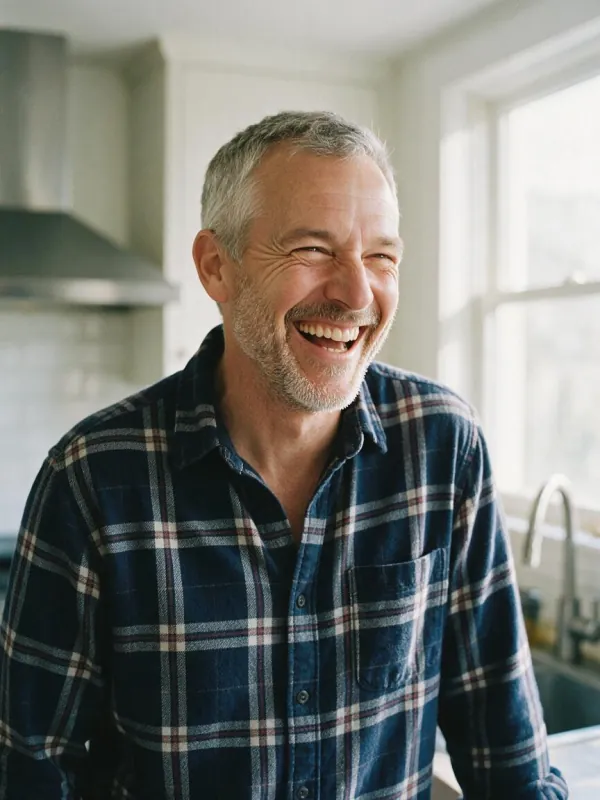
Candid photo of a man in his early fifties with short grey hair, a short grey beard and laugh lines, wearing a navy plaid flannel shirt, laughing in a bright kitchen with morning light. Natural, realistic editorial photo, 35mm film look. The person is a fictional adult.
厨房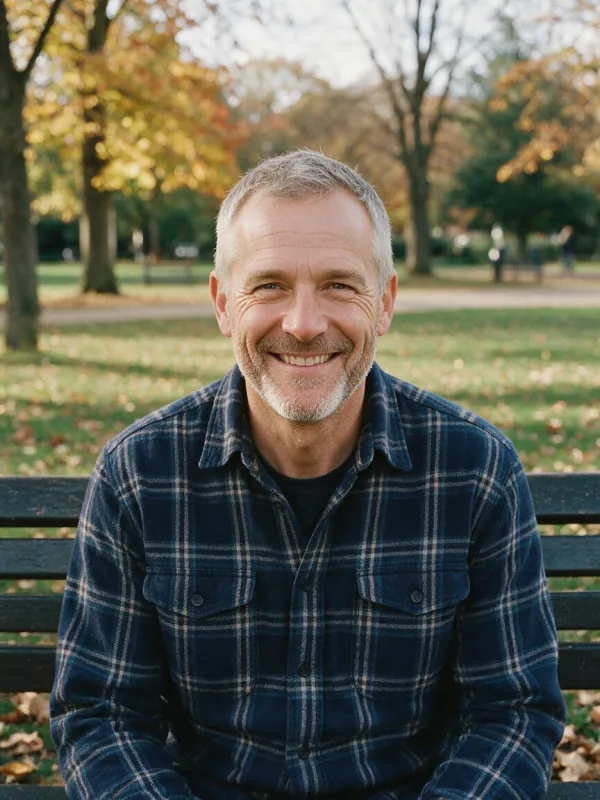 公园长椅
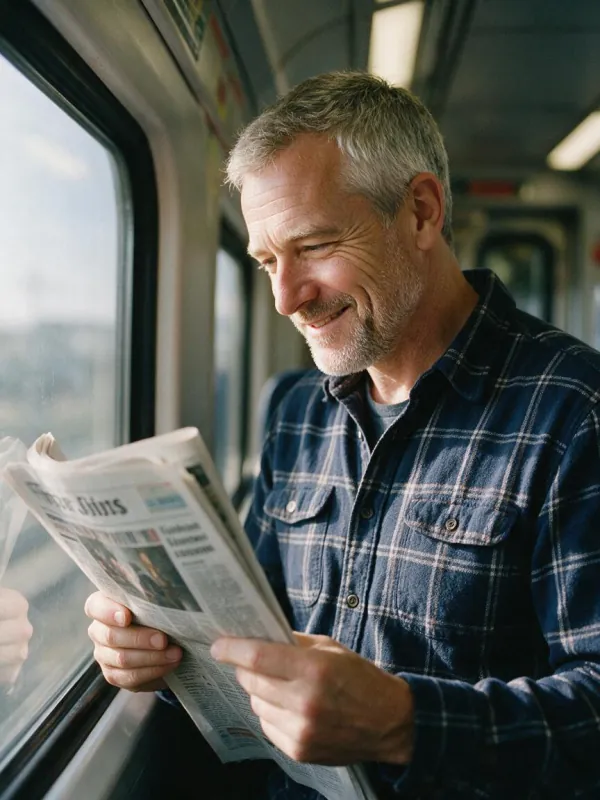 火车
每张图都符合文字描述,但没有一张是同一个人。描述只能把人框成一类:「五十来岁、短灰发、短灰胡子」的人有成千上万张脸,模型每次都挑一张新的。再多加形容词也解决不了这个问题。
解决办法:每张图都从同一张参考图出发
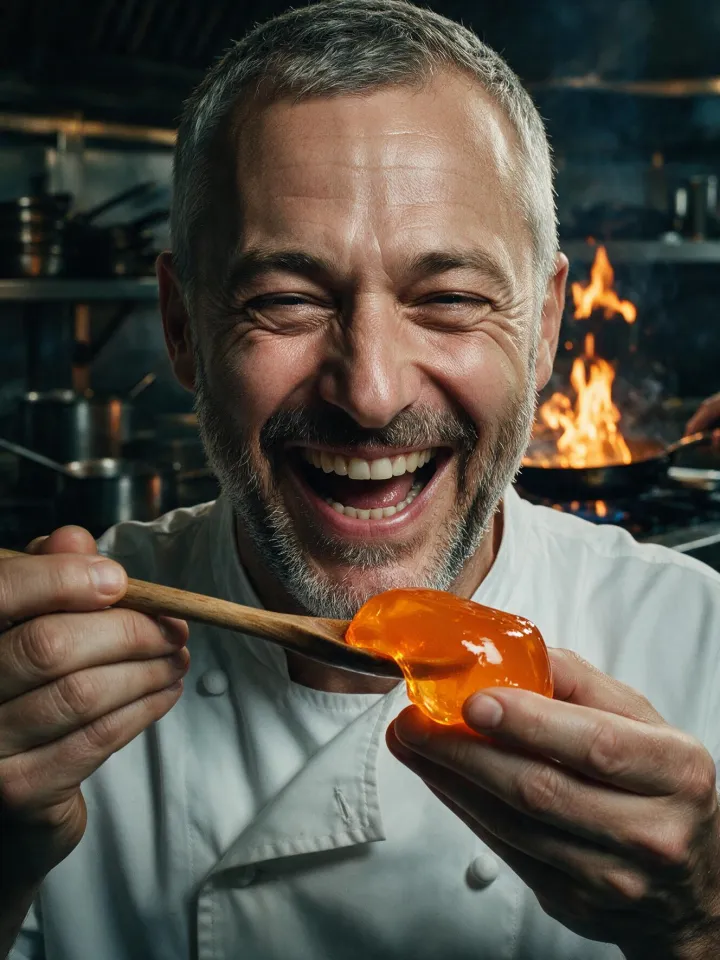
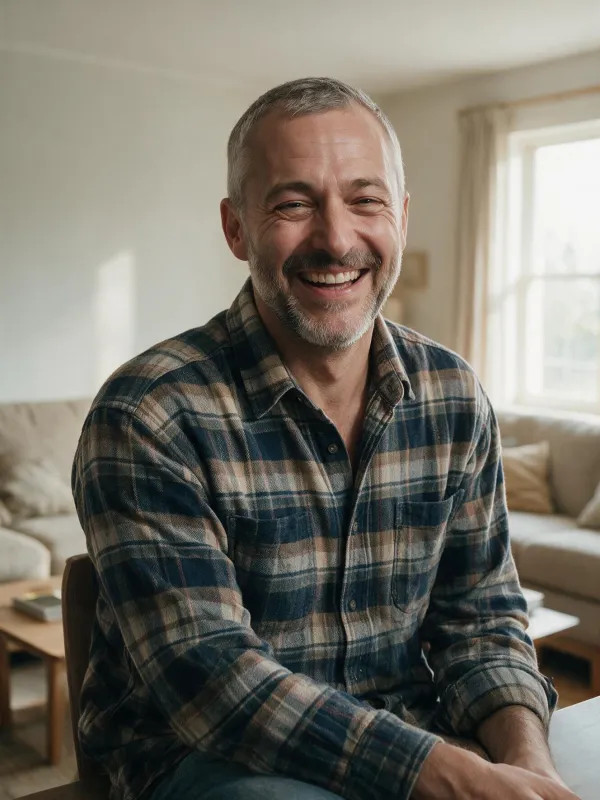
先做出(或上传)一张清晰的正面肖像,然后每张新图都用图像编辑模型生成,并把这张肖像作为参考图附上。这是 Theo,我们在AI 网红页面上创建的虚构厨师:
以这张肖像为起点,角色套图页面生成了一组六张「居家」主题的新照片,每张的房间、服装、取景和姿势都不同:
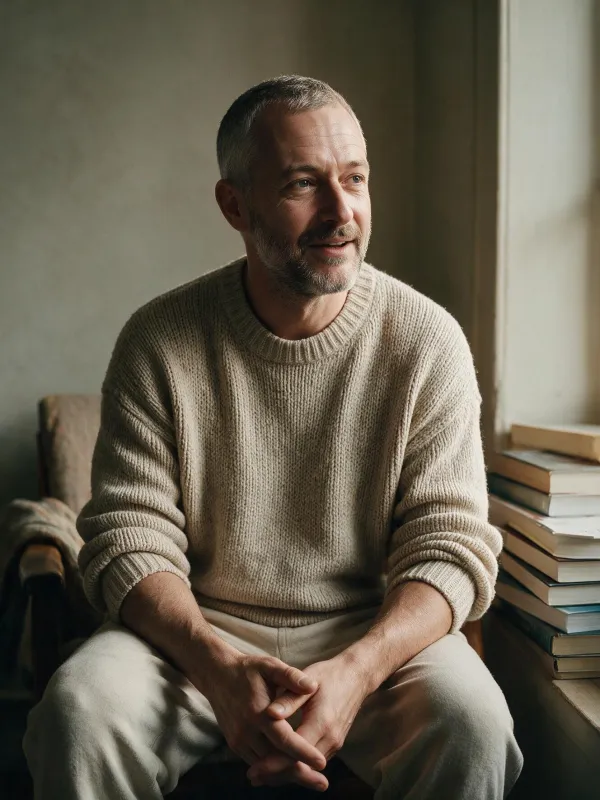 阅读角
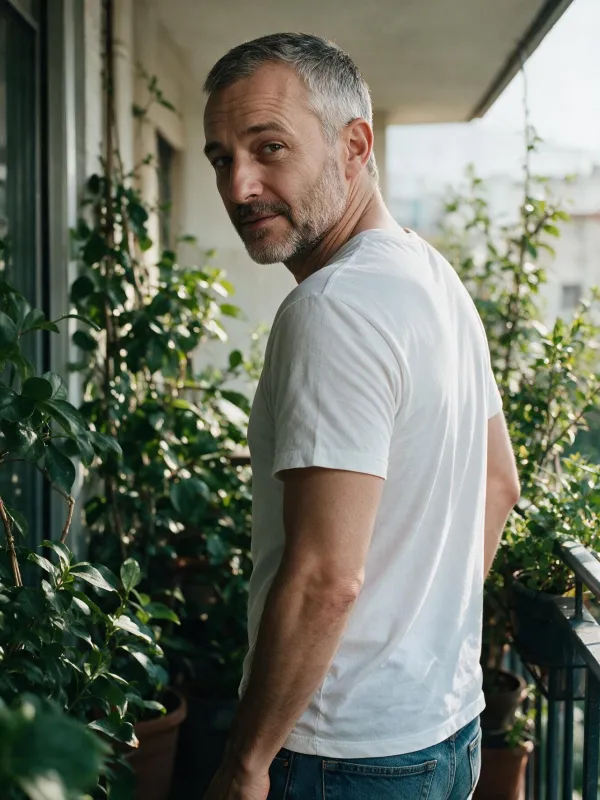 阳台
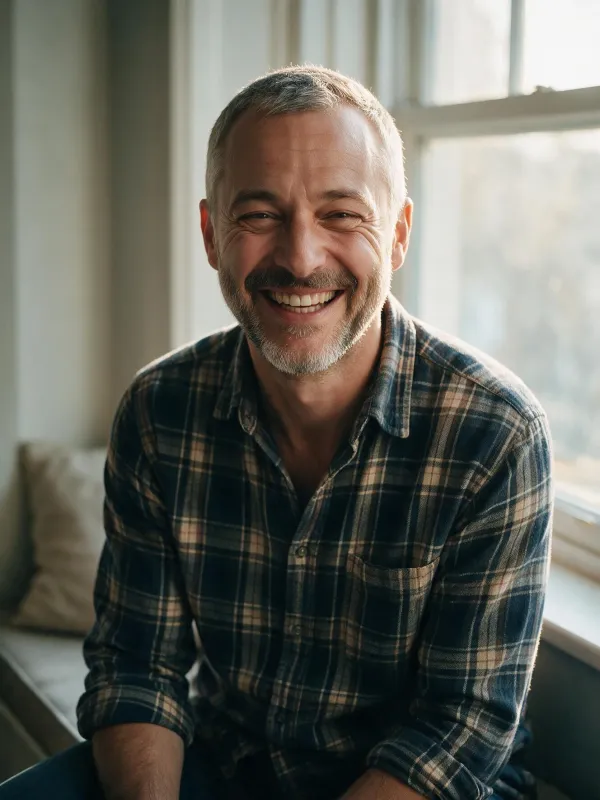 窗台
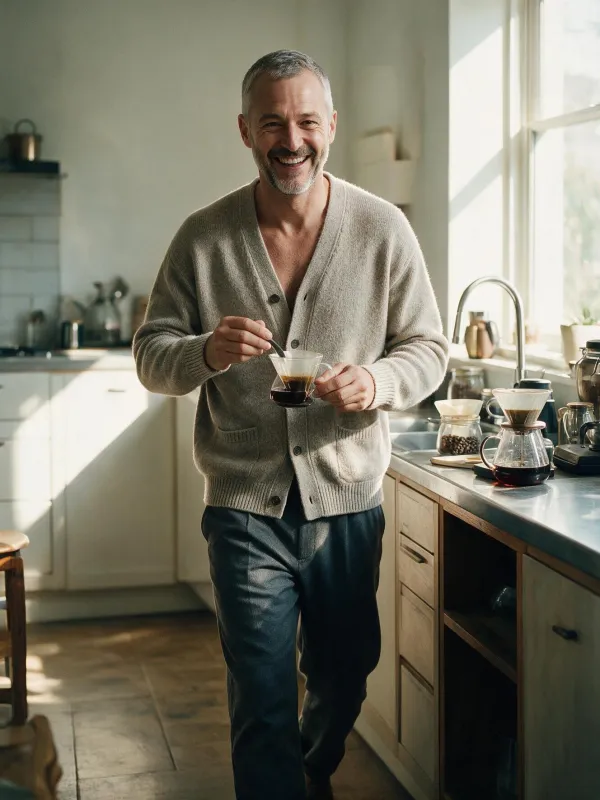 厨房
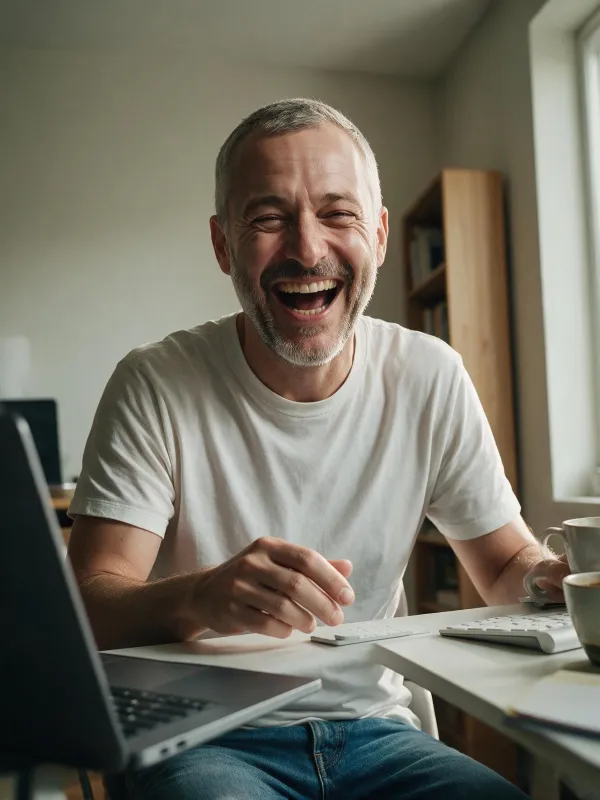 家庭办公室
 客厅
每张照片都是带着这张肖像做的一次编辑。下面是厨房那张的提示词:
The same character as in the reference image, with exactly the same face, hair and identity. A full-length fashion photo of them walking toward the camera, wearing a relaxed cardigan, in a sunny kitchen making coffee. Natural, realistic editorial photo with strong styling and beautiful light. The person is an adult and stays fully clothed.
这一整套六张,1K 下花了 216 积分。角色套图页面会替你写这些提示词:选一个主题,再选 4、8 或 12 张即可。
好的参考照片是什么样的
参考图决定了后面的效果好不好。最好的参考图通常具备以下几点:
- 脸要清楚,正面或微侧。 两只眼睛都要看得见,不戴墨镜,嘴巴没有被遮住。
- 光线均匀。 脸上的硬阴影会被当成脸的一部分照搬下来。
- 只有一个人。 合照里,模型可能会从别人身上借五官。
- 你想保留的细节要在。 如果角色总戴眼镜,或者有疤痕、纹身,要确保这张图里能看到。
- 脸要够大。 脸应该占画面的较大部分。广角里的小脸给模型的参考素材太少。
你自己的照片也一样。把它作为参考上传,就能做出一套属于你自己的套图。
提示词怎么写,脸才能保持住
- 开头就锁住。 把「The same character as in the reference image, with exactly the same face, hair and identity.」放在最前面,早于地点和服装。
- 每张只改一两样。 换地方和服装,或者换取景和姿势。一次全改,最容易走样。
- 每次都回到原图。 所有新图都从第一张参考图生成,不要从上一张结果再生成。复印件的复印件,每代都会漂移一点。
- 为任务选模型。 在 PopNow 上,Seedream 5.0 Pro 最适合做套图;最在乎像不像的时候,可以试试 Nano Banana 2.1。
如果是在图片或视频页面上操作,在提示词框里输入 @,就能把保存好的角色拉进请求,不用再上传一次参考图。
把同一个角色带进视频
视频里角色最容易崩,因为模型要在一百多帧里都保住脸,而不是一张图。可靠的做法还是同一个思路:让视频从一张已经有正确脸的照片开始。我们拿上面套图里的厨房照片,用 MiniMax H3 让他动起来:
He walks toward the camera holding the coffee cup, takes a sip and laughs at something off-camera while the camera slowly pulls back. Soft kitchen ambience, a spoon clinking.
这段视频花了 185 积分,不到一分钟就完成了。场景更长的话,可以从套图的不同照片各做几段,再剪在一起;或者用视频生成器里的参考模式,有些模型可以一次接收同一个人的多张照片。想了解怎样把视频做长、拼接片段,可以看我们的如何把 AI 视频做长指南。
常见问题
AI 图片怎么保持同一张脸?
用参考图代替文字描述。先生成或上传一张清晰的肖像,然后每张新图都用编辑模型从它出发,提示词开头写上「the same character as in the reference image, with exactly the same face, hair and identity」。
哪个 AI 最适合做一致的角色?
能从参考图编辑的模型最能保住脸。在我们的测试中,Seedream 5.0 Pro 在六张的套图里保住了脸;最在乎像不像时,就选 Nano Banana 2.1。纯文字生成的话,哪个模型都做不到。
能用我自己的照片做一个一致的角色吗?
可以。在角色套图页面上传你自己的照片作为参考,再选一个主题即可。请只使用你本人的照片,或已经同意的人的照片。
卡通和动漫角色也适用吗?
适用。方法一样,只是提示词会要求保持完全相同的画风,而不是写实照片。动漫方面,动漫页面有专门为此做的「同一角色」模式。
做一套一致的角色要花多少?
在 PopNow 上,用 Seedream 5.0 Pro 做一套六张 1K 照片要 216 积分;用 MiniMax H3 在 768p 下把其中一张做成 5 秒视频要 185 积分。生成前都会先显示价格。