什么是 PopNow 数字人口播?
「数字人口播」是 PopNow 的 AI 口播视频生成器。你提供角色、声音和几句台词,就能得到一段竖版口播视频,样子就像人们正在刷的那些格式:街头采访、车内自白、产品测评、播客片段等等。
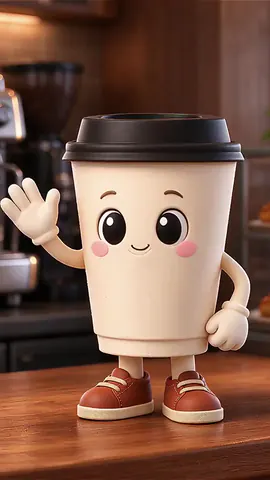
角色可以是你本人、品牌吉祥物的照片,也可以是虚构的人物。声音可以是我们提供的声音、你自己声音的克隆,或者你上传的录音。照片会动起来,嘴型跟着音频走,头部和脸部也会自然移动。
使用方法
- 选择格式从一个爆款格式开始。每个格式都会配好对应的表演风格和一段可以改写的起始台词。
- 添加你的角色上传一张正面、清晰的照片,从你的素材里选一张,或者试试示例角色。
- 选择声音选一个声音,使用你在「我的声音」里克隆的声音,或者上传 3 到 60 秒的音频。
- 写台词输入角色要说的话。价格随时长变化,你写的时候就能看到它的变化。
- 生成我们会用你选的声音读出台词,再让照片做出说话的动作。下载、发到编辑器或直接发布都可以。
- 街头采访 街上有人把麦克风递到你面前,一个快速的故事。
- 车内故事 车停好,手机架在仪表盘上,直接对着镜头讲。
- 产品测评 以第一人称诚实地评价你试过的一样东西。
- 播客片段 麦克风后面抛出一个犀利观点。
- 字幕口播 快节奏的口播,配上逐字放大的大字幕。
- 群聊故事 通过群聊讲故事,你在一旁吐槽反应。
- 想象与现实 你想象中的样子,然后是真实发生的事。
- 电话段子 和一个你绝对想不到的人打的单方面电话。
- 剧情反转 平静的铺垫,最后揭晓答案。
- 点击修改 你一边说,身上的某些东西一直在变。
让口播更好的小技巧
- 照片里的脸要大、清晰、光线均匀。帽子、手或头发挡住嘴,会让口型同步变差。
- 像平时说话那样写:句子短,每句一个意思,开头第一句就要抓人。
- 发在信息流里,尽量控制在 20 秒以内。台词太长成本更高,也容易流失观众。
- 声音要和角色匹配。平静的声音适合车内故事,活泼的声音更适合测评。
请负责任地使用
只使用你拥有或已获得授权使用的照片和声音。如果你上传的是别人的照片或声音,我们会请你确认已获得对方同意。不要用 PopNow 数字人口播误导他人,让人以为某句话是某人说的。
价格
按音频时长收费:每秒口播视频约 18 积分,另加一小笔费用用于以该声音朗读台词。一段 10 秒的口播视频约 184 积分。开始前,准确价格会显示在「生成」按钮上,失败的任务会退款。
常见问题
做口播视频需要准备什么?+
一张你角色的照片、一段声音,以及想让它说的台词。你可以先用示例角色和我们提供的声音试一试,然后再换成你自己的照片和声音。
可以用我自己的声音吗?+
可以。先在「我的声音」里录制或上传一段短样本,克隆一次你的声音,然后在 PopNow 数字人口播里选择「我的声音」。你也可以直接上传一段完整的台词录音,时长 3 到 60 秒。
会自动添加字幕和画面图形吗?+
暂时不会自动添加。PopNow 数字人口播负责生成口播视频;之后可以在 PopNow 编辑器里添加逐字字幕、聊天气泡或弹窗。
什么样的照片效果最好?+
正面照片,脸部清晰可见,嘴巴没有遮挡。人像和自拍效果很好;嘴巴清晰的卡通角色和吉祥物也可以。
口播视频最长能有多长?+
大约一分钟的语音。在社交信息流里,8 到 20 秒通常效果最好,而且更短的视频也更省钱。
可以商用这些视频吗?+
可以。你做的视频归你使用,包括广告和你的频道,前提是你对所用的照片和声音拥有相应的权利。

 AI 口播视频生成器:你的角色、你的声音、你的台词