先做一张角色参考图,反复把它作为参考使用,每次修改只动一处。从静态图到多镜头视频,脸、发型和服装都能保持一致,不再逐条重新碰运气。
只用文字描述的角色,每次运行都会被重新画一遍。即使是同一句话,下巴线条、发际线和外套也会在每次结果之间漂移。一致性来自图片,而不是形容词:做一张好的参考图,然后把它交给每一个镜头。
步骤 1:做一张参考图
从你有权使用的照片开始,或者用你生成并喜欢的一张静态图。把它做成参考图:同一个人站在纯色背景前,几个全身角度(正面、侧面和背面)加上几张面部特写,风格与原图一致。技能 中的角色转面技能可以帮你生成这张图。把结果保存到 角色 中,下次一键就能用。
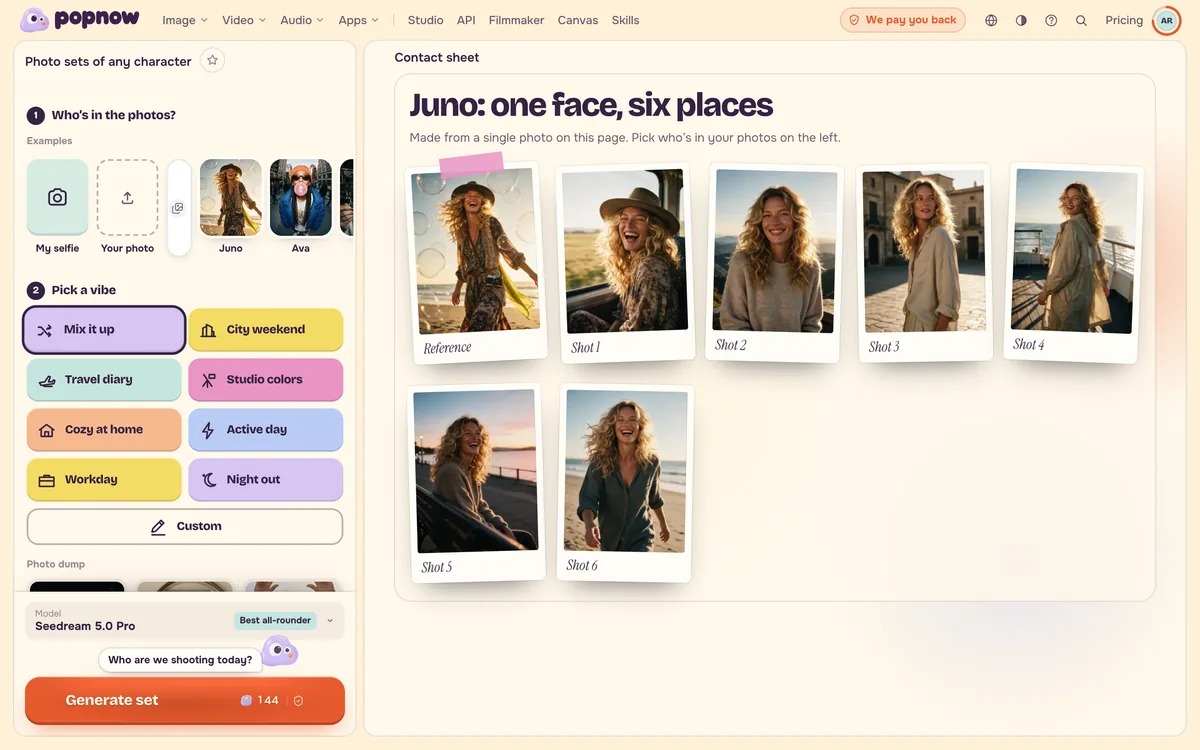
步骤 2:把参考图作为参考使用
生成新的静态图时,把参考图添加为参考,并说明要保持什么。没有这句话,模型会把参考当作松散的灵感。
Place the person from the photo on a windy harbour pier at golden hour, keeping their face, hair and green raincoat exactly as they are; soft side light from the low sun.
步骤 3:每次修改只改一处
姿势、场景、服装和光线是四种不同的改动。每次只改一项,脸就能保持。如果一次改四项,模型就得把画面的大部分重新发明,人物就会漂移。两次快速修改通常比一次拥挤、最后还要重做的修改更省。如果你确实要一次改好几处,提示词框旁的 智能增强 会保留所有改动,把你最想强调的那一项放在最前,并写明什么必须保持不变。
步骤 4:把角色带进视频
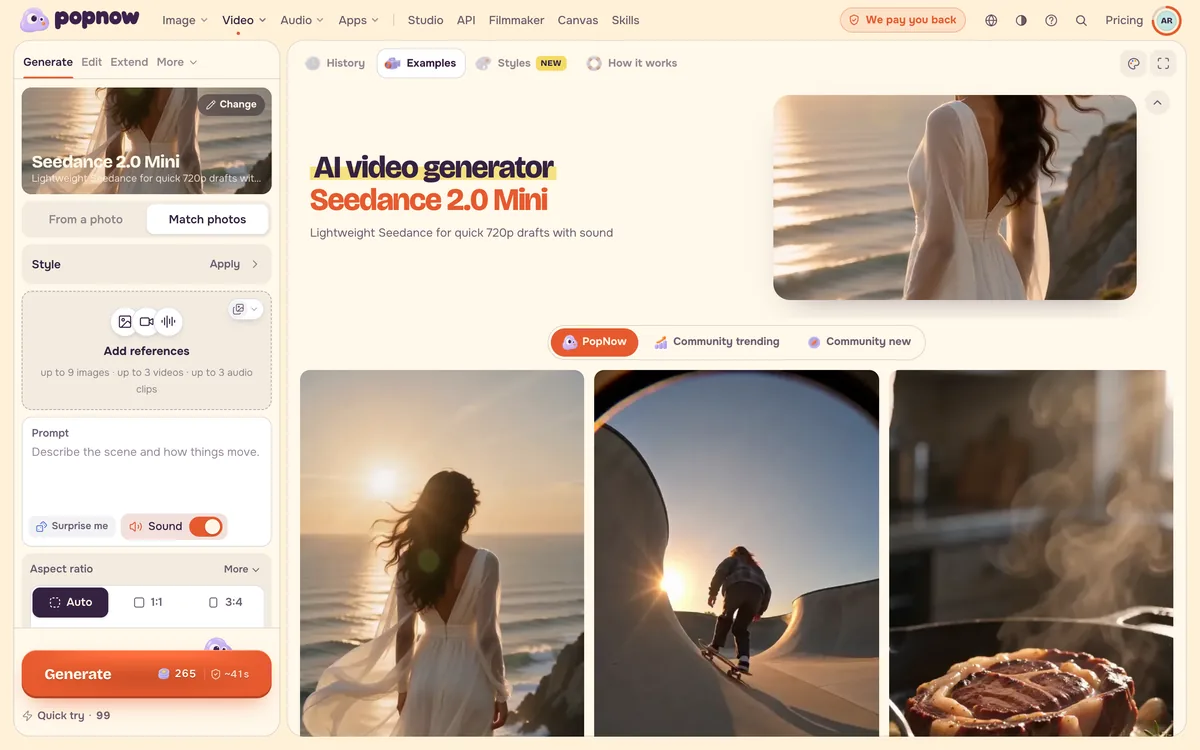
在视频页面切换到 照着这些照片(参考生视频),添加参考图,以及你有的场景照片。每个参考都有一个可在提示词中使用的标签,例如 @Image1,所以要说明哪张图是什么:「来自 @Image1 的女人走进 @Image2 的咖啡馆」。每个片段里需要保持可辨认的人物最多三个,并且每个镜头都要写清楚哪个人在做什么。若要在一段视频中放入多个镜头,参见 一段视频里的多个镜头。
常见问题
为什么我的角色在不同片段之间脸会变?
通常是片段只用文字生成,或者添加参考时没有说明要保持什么。加上参考图,写「与参考图相同的脸、发型和服装」,并避免在同一次运行中同时改变姿势、场景和服装。
应该用几张参考照片?
同一个人的三到四张清晰照片,通常比一张更好。让每张图只负责一件事(脸、服装或场景),并在提示词中说明哪张是哪一个。
可以用别人的照片吗?
请只使用你自己的照片,或已经同意的人的照片,不要使用公众人物的照片。PopNow 上的示例都使用虚构的人物。