从你手上已有的东西开始。根据是一句话、一张照片、一组人物照片还是一段视频,匹配合适的 PopNow 模式和首个型号,几分钟内拿到可用的结果,不白白浪费积分和重来的次数。
最容易浪费积分的,是从错误的地方开始:明明已经有一张照片,却从零描述;或者只因为一个细节不对,就整段重新生成。动笔之前,先看看手边已经有什么,再打开从它开始的模式。
步骤 1:说清你已经有什么
起点一共有四种:文字、一张照片、同一个人或同一件产品的几张照片,以及一段视频。每一种能定下的东西都不一样。只有文字,什么都没定,模型要凭空想出整个画面。一张照片能定下人物、地点和光线。同一主体的几张照片能定下出现的是谁或什么。一段视频还能定下动作和节奏。
从你手上最完整的素材开始。每个已经定好的细节,都是模型少猜一件事。
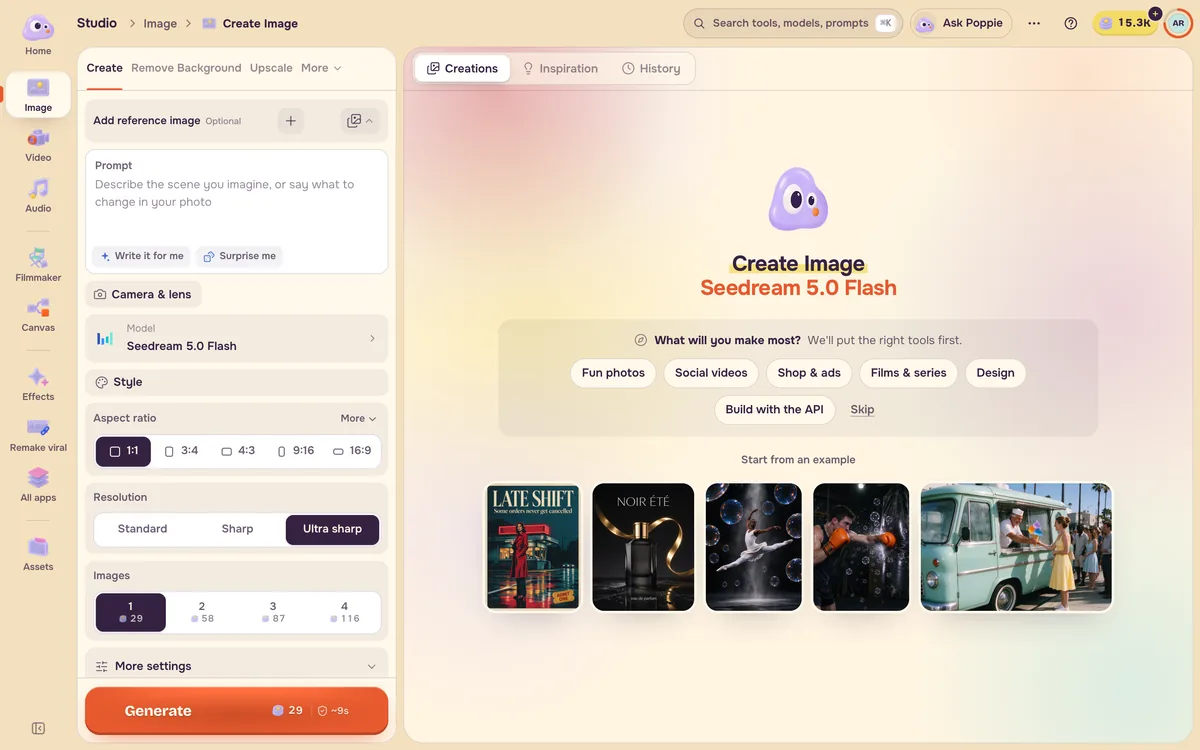
步骤 2:打开对应的模式
下表中的每种组合,都从 Studio 左侧栏打开。
| 你有 | 你想要 | 打开 |
|---|---|---|
| 文字 | 一张静态图片 | 图片 → 生成图片 |
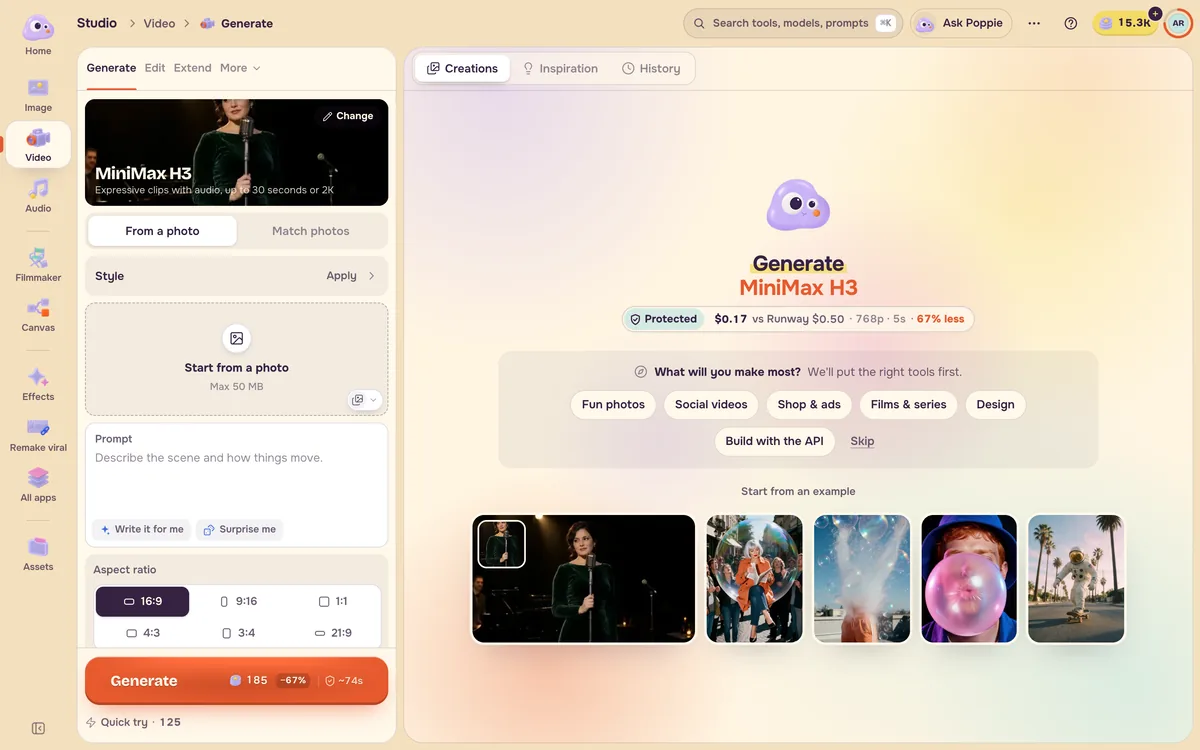
| 文字 | 一个动态镜头 | 视频 → 生成 |
| 一张照片 | 同一张照片,但做些修改 | 图片 → 生成图片,把照片作为参考 |
| 一张照片 | 让这张照片动起来 | 视频 → 生成 → 用照片开头 |
| 同一人物或产品的多张照片 | 保持他们不变的视频片段 | 视频 → 生成 → 照着这些照片 |
| 一段视频 | 同一段视频,改一处 | 视频 → 编辑,或 视频替换 |
| 一段视频 | 同一镜头的延续 | 视频 → 续写 |
| 一句台词,或脑中的一种声音 | 人声、音乐或音效 | 音频 |
步骤 3:第一次运行先用推荐型号
每种模式打开时,都已经选好了推荐型号,并在型号列表顶部标注为「自动」。它是为了稳定、价格合理而挑选的,所以第一次的结果能告诉你创意行不行,而不是某个少见的型号合不合适。等你知道想改进什么,再换型号。按下生成之前,价格一直显示在生成按钮上。
快速判断
- 如果你想说的是「让它动起来」,就从照片开始。
- 如果你的想法里有「同一个人」,就从这个人的几张照片开始。
- 如果你喜欢某段视频,只是有一处不对,直接编辑它,不必从头来。
- 如果声音才是重点(一段对白、一段旋律、一个节拍),先做声音。
常见问题
可以先从文字开始,之后再加照片吗?
可以,而且常常更省积分。先做一张静态图,留下满意的版本,再打开视频,从它开始。静态图重做很便宜,视频重做却不便宜,所以趁它还是图片时就把画面定下来。
照片很小或很模糊怎么办?
视频模型会把首帧拉伸到输出尺寸,所以模糊的照片会变成模糊的视频。当起始照片明显太小或太模糊时,视频页面会在上传位下方显示 先放大。清晰的版本会直接回到你的视频中,作为起始帧。参见 照片转视频。
推荐的型号总是最便宜的吗?
不一定。它是该模式下稳定可靠的默认选择。每个型号页面都会把同一系列中更便宜和更清晰的版本排在一起,并显示实时价格,所以你可以先用便宜的版本试想法,再用更好的版本完成成片。参见 少花积分。