制作 AI 视频,就是写一段单个镜头的描述(画面里是谁、做什么、镜头怎么动、有什么声音),选一个视频模型,然后点生成。大约一分钟就能拿到一条 5 秒的片子。在 PopNow 上,默认模型 MiniMax H3 做一条带声音的 5 秒片子约 185 积分。如果你想精确决定第一帧长什么样,就从一张图开始,而不是从文字开始,这叫图生视频。
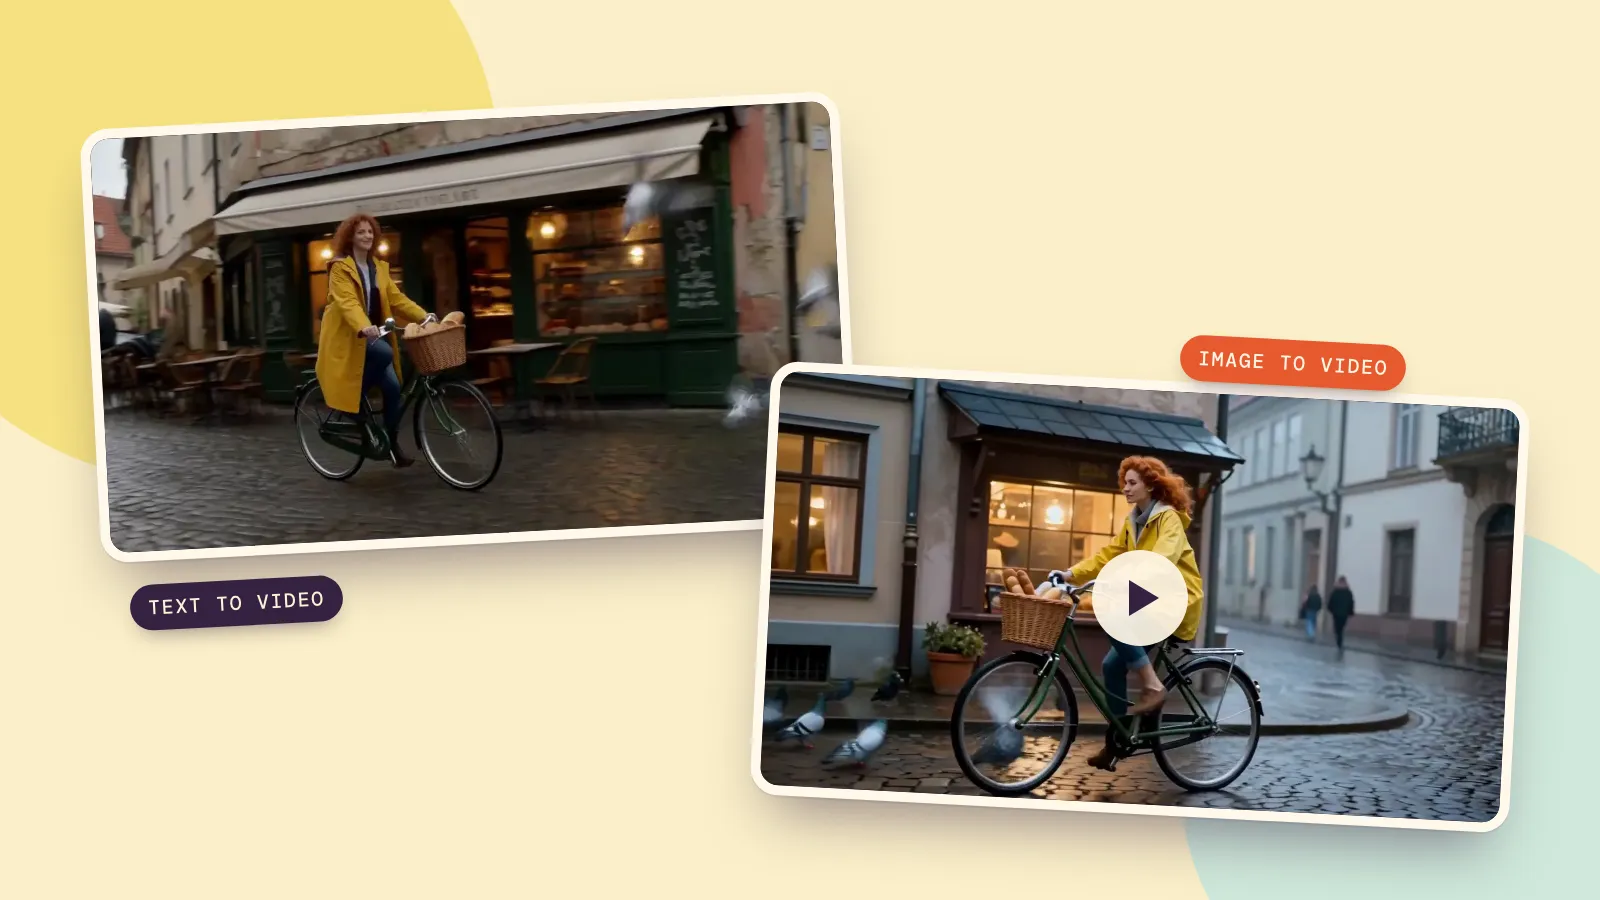
流程就这些。本页其余部分讲的是决定片子好坏的那部分:写什么、从哪种起点开始、以及该有什么预期。我们在 2026 年 10 月 17 日用同一个场景做了两种片子,两条都放在本页,并附上了完整提示词。
两种做 AI 视频的方式
| 文字生成视频 | 图片生成视频 | |
|---|---|---|
| 你提供 | 一段文字描述 | 一张图加一段动作描述 |
| 适用场景 | 有想法但没有图 | 需要指定人脸、商品、服装或构图 |
| 你能控制 | 剧情和镜头 | 首帧的确切画面 |
| 注意 | 模型自行决定细节 | 动作必须从那个姿势开始 |
大多数新手应该先从文字生成视频开始。这是了解模型如何理解你的文字最快的办法。当画面效果很重要时,再改用图生视频:比如你自己的商品、已经设计好的角色,或是想让一张照片动起来。
如何用文字生成 AI 视频
- 打开视频生成器。 它打开时默认选中 MiniMax H3,画质 768p、比例 16:9、时长 5 秒。
- 写一个镜头。 用一段话描述主体、动作、镜头和声音。五秒内放一两个动作比较合适,放整个故事就不行了。
- 选画幅。 16:9 适合 YouTube 和电脑,9:16 适合手机,1:1 适合信息流。
- 看按钮上的价格,然后点生成。 按钮会在开始前显示确切的积分。如果片子失败,积分会退回。
- 看完后只改一处。 如果镜头动得不对,只改镜头那一句再跑一次。一次改很多处,就很难知道是哪一处起了作用。
这是我们用的提示词,按有效的结构写成:
Early morning on a wet cobblestone street in an old European town. A woman in her late twenties with curly red hair and a yellow raincoat rides a vintage green bicycle with a wicker basket of bread past a small bakery with warm glowing windows. She rings the bell and smiles as a few pigeons take off from the stones in front of her. Camera: a smooth side tracking shot that keeps pace with her. Sound: the bicycle bell, tires on wet stones, fluttering wings and a quiet town waking up.
这是按下生成后 32 秒拿到的结果:
效果好的地方:雨衣、自行车、面包篮、发光的面包店和湿漉漉的石板路,还配上了声音。有变化的地方:她一开始是朝镜头骑过来,而不是横向经过;面包店招牌上的字是乱码。这两点都很典型。模型会把镜头指令当作参考,而且在视频里还没法可靠地写出招牌上的字。如果店名很重要,就从一张招牌已经正确的图开始。
如何用一张照片生成 AI 视频
- 准备首帧。 用你自己拍的照片,或者在图片生成器里做一张。我们是用同一个场景的一段描述生成的这张图。
- 打开视频生成器并添加图片。 选择「从照片开始」,把图放进「首帧图片」。视频的画幅会跟着这张图走。
- 只描述动作。 图片已经画出了是谁、在哪里,所以提示词只需要写接下来发生什么、镜头怎么动,以及声音。
- 生成。 用 MiniMax H3 做一条 5 秒片子约 185 积分,和文字生成视频价格一样。
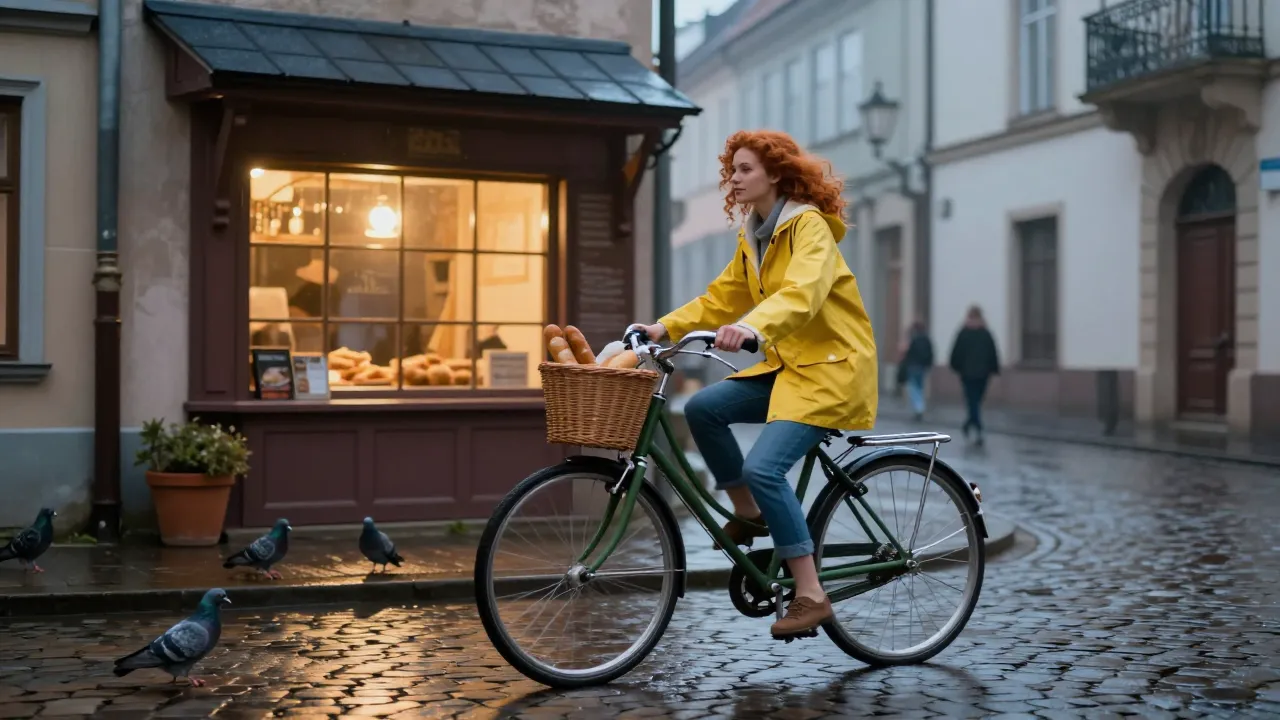
我们用的动作提示词是:「她沿着湿润的鹅卵石路继续蹬车,按响车铃并微笑;她前面的鸽子飞向空中。镜头沿着她平稳跟拍。」这条片子 46 秒后生成:
这次镜头确实跟在她身边移动,一只鸽子正好在车轮前飞起,而且从第一帧到最后一帧,她的脸、头发和外套都和静态图完全一致。这才是图生视频真正的优势:模型不用凭空创造画面的样子,所以能把精力放在动作上。
如何为 AI 视频写提示词
好的视频提示词读起来应该像导演说的一段清楚的话,而不是一串关键词。按这个顺序写四个部分:
- 主体。 是谁或什么,加上两三个关键细节:「一个二十多岁、卷发、穿黄色雨衣的红发女人」。
- 动作。 五秒内发生的一两件事:「按响车铃并微笑,这时鸽子飞起」。
- 镜头。 一种运动:跟拍、缓慢推近、静态远景、手持特写。如果你不熟悉这些词,提示词框下面的「运镜」按钮里有十几种现成的运镜可选。
- 声音。 写出你想听到的声音。能生成音频的模型对这一点的跟随效果出奇地好。
有三个习惯可以省积分:每条片子只放一个镜头;描述你想要的,而不是你不想要的;每次重跑只改一样东西。
用哪个模型,要花多少钱
PopNow 上有几十个视频模型,模型库列出了每一个并附有示例。第一条视频,这三个基本够用:
- MiniMax H3,默认模型。动作和声音都不错,不用想设置:5 秒 768p 约 185 积分。
- Seedance 2.0 Mini,480p,适合边调提示词边快速出草稿:5 秒约 124 积分。
- Kling 3.0,需要 1080p 或 4K、动作更自然时选它;各画质的价格见它的模型页。
需要多个镜头?把每个镜头各做成一条片子,再拼起来;或者用延长接着上一条片子的最后一帧继续往下做。如果你只想输入一句话,就得到一条带多个镜头、旁白和配乐、已经剪好的成片,那就用 AI 视频制作器:它会写好方案、做出每个镜头,再剪在一起。
常见问题
做 AI 视频能免费吗?
在 PopNow 上按条付积分,没有订阅。一条 5 秒的 MiniMax H3 片子约 185 积分,5 秒的 Seedance 2.0 Mini 480p 草稿约 124 积分。所以先用便宜的 480p 草稿测试提示词,再花钱做更清晰的版本,是最省的办法。如果生成失败,积分会退回你的余额。
做一条 AI 视频要多久?
我们的两条 5 秒片子分别用了 32 秒和 46 秒。更长的片子、更高的画质和高峰时段都会更慢;几分钟是正常的。
能用我自己的照片做 AI 视频吗?
可以。把照片作为首帧添加,再描述动作。请使用你本人的照片,或已经同意的人的照片,并确保脸部清晰可见。
AI 视频有声音吗?
现在很多模型可以随画面生成声音。MiniMax H3 根据我们的提示词自己加上了车铃、轮胎和街道的声音。其他模型,比如 Kling 和 Seedance,可以开关声音。
AI 视频能做多长?
大多数模型每条生成 5 到 10 秒,有些能到 15 秒或更长。更长的视频可以做几条再拼接,或者每次延长几秒。