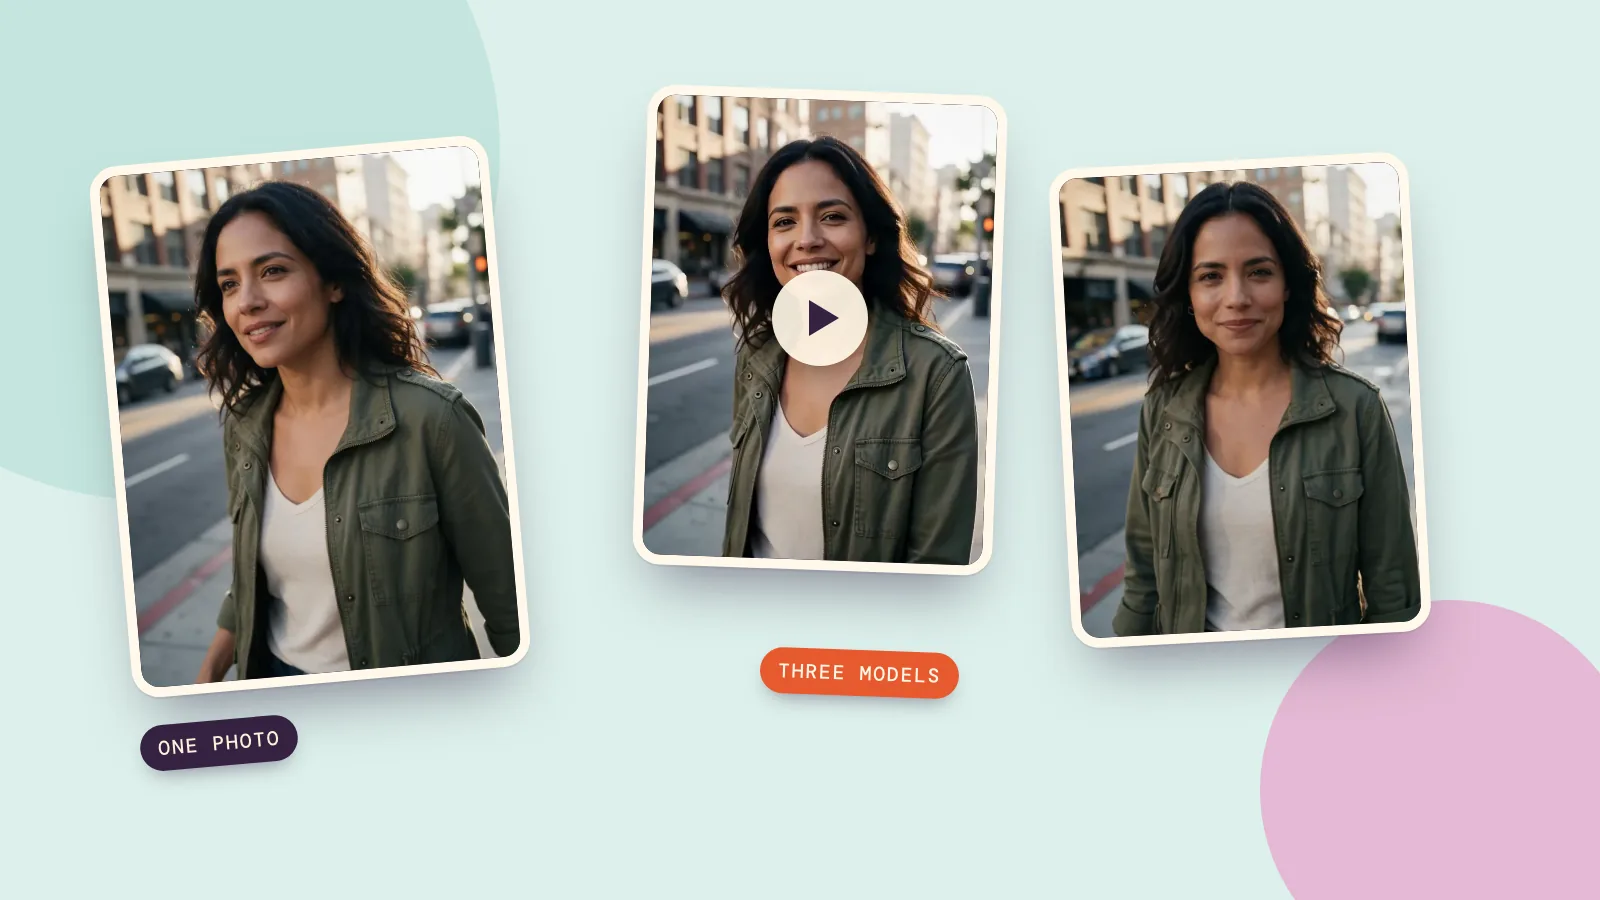
要用 AI 把图片转成视频,先打开图生视频工具,把照片作为第一帧上传,写一句想让画面怎么动,选一个视频模型,然后点生成。大约一分钟后,你就能得到一段 5 秒的短片,它正好从你的照片开始。
我们用一张人像、一句提示词,在三个不同的视频模型上做了测试,让你看到换模型时会有什么变化:动作、人脸、声音、速度和价格。
第一步:选一张适合动起来的照片
视频的第一帧就是你的照片,所以照片决定了大部分结果。以下这类照片效果最好:
- 一个清晰的主体,在画面里占得大,并且脸可见。
- 清晰、光线好。 照片里的模糊会变成视频里的模糊。
- 有活动空间。 正在走路的人前面有空间可以走;紧贴画面边缘的人就没有。
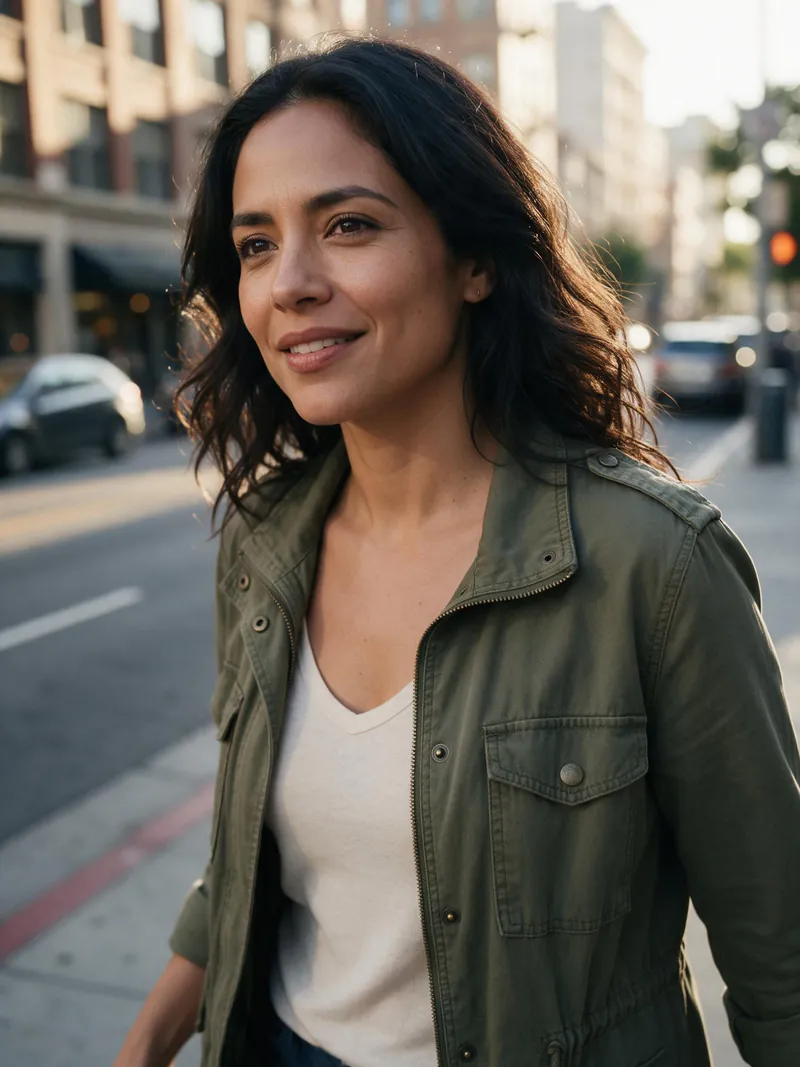
下面是我们用的照片:一位女士在黄昏的街道上,身后是虚化的城市,这是一张人像。
第二步:写一句关于动作的话
你不需要描述照片,模型已经看到了。你要描述的是接下来会发生什么。我们三个模型用的是同一句提示词:
She turns her head toward the camera and smiles, her hair and jacket moving gently in the breeze as she walks forward slowly, the camera drifts in a little. Natural city street sound.
公式很简单:谁做什么、布料或头发怎么动、镜头怎么动。 只写一个动作。「慢慢向前走并微笑」对模型来说很容易;「先走、再跳舞、然后挥手」就是人脸开始走样的地方。
第三步:选模型,看三种结果
三段视频都是 5 秒,用同一张照片和同一句提示词生成。
MiniMax H3
她转身、微笑、朝镜头走来,头发和夹克的摆动都和提示词要求的一致。配乐跟随了提示词里「自然的城市街道声」这句。费用:185 积分。
Kling 3.0
Kling 给出的表情最平静、最自然:是一个小而放松的微笑,而不是大笑,三者中皮肤细节也最清晰。声音默认关闭,所以这段是无声的。费用:336 积分。
Seedance 2.0 Fast
三者中最快,画面尺寸也最小(480p)。动作比另外两个更柔和。在你花更多钱做最好的那一个之前,它很适合先试五个想法。费用:225 积分。
并排对比
| MiniMax H3 | Kling 3.0 | Seedance 2.0 Fast | |
|---|---|---|---|
| 我们跑的分辨率 | 768p | 720p | 480p |
| 声音 | 有 | 默认关闭 | 有 |
| 生成时间 | 约 80 秒 | 约 130 秒 | 约 40 秒 |
| 5 秒的费用 | 185 积分 | 336 积分 | 225 积分 |
| 最适合 | 声音和更生动的表演 | 自然的脸 | 快速草稿 |
三段里,她的脸、头发和夹克在整段视频中都与照片保持接近。这正是图生视频模型该有的表现:让你的照片动起来,而不是把它替换掉。
第四步:下载、延长或使用特效
视频生成好后就可以下载。如果想要更长,可以从最后一帧延长视频。如果根本不想写提示词,视频特效是一键版的创意,比如气球升空、跳舞或拥抱。只需添加一张照片。
管用的提示词
- 走路。 「她慢慢朝镜头走来,风吹动她的头发。」
- 人像。 「他抬头微笑,轻轻点头。镜头缓慢推近。」
- 宠物。 「狗狗摇头摆尾,镜头保持不动。」
- 商品。 「镜头缓慢环绕马克杯,杯口升起热气。」
- 风景。 「云朵飘过天空,湖面泛起涟漪。」
常见问题
- 脸变了。 把提示词缩短到一个动作,然后用同一张照片换第二个模型试试。
- 几乎没动。 加一个镜头动作(「缓慢推近」)和一个身体或布料的动作(「她的围巾轻轻飘动」)。
- 结尾看起来怪。 要 5 秒,不要 10 秒;大多数模型在前五秒最稳定。
- 想要声音。 模型提供时就打开音频,并把声音写进提示词(「雨打在窗户上」)。
如果同一个角色要出现在很多段视频里,可以先在角色里做好这个角色,然后每次都用它作为起始照片。
常见问题
怎么用 AI 把照片变成视频?
在图生视频工具里把照片作为第一帧上传,写一句关于动作的话,选一个模型然后生成。根据模型不同,结果是 3 到 15 秒的片段。
能免费把图片转成视频吗?
在 PopNow 上并不免费,但用一个快速模型做一次简短的测试,只需要几个积分。按段计费,没有订阅,生成前会先显示价格。
哪个 AI 最适合把照片转成视频?
这取决于你要什么。在我们的测试里,MiniMax H3 的表演和声音最生动,Kling 3.0 的脸最自然,Seedance 2.0 Fast 最快也最便宜。可以先用你的照片试两个。
视频能做多长?
每个模型都有自己的上限,一般每段 5 到 15 秒。想要更长,就从最后一帧延长,或者把几段拼起来。
视频会保留人的脸吗?
在我们的三段视频里,都保留了。用清晰、脸部可见的照片,只要一个动作,并避免幅度大的动作,相似度最好。