Sand.ai 出品影片
daVinci-MagiHuman
給臺詞加上引號,畫面中的人就會把它說出來
- 最高 1080p
- 5–10 秒
120 點起 (5 秒影片)≈ US$0.12· 生成影片
實際用起來如何
daVinci-MagiHuman 是 Sand.ai 與 SII-GAIR 推出的開源模型,可以同時生成畫面與聲音:給臺詞加上引號,畫面中的人就會把它說出來。它可以根據提示詞或起始照片生成 5 到 10 秒的片段,解析度為 256p、720p 或 1080p,畫面比例為 16:9 或 9:16。
適合用來
- 一位主持人對著鏡頭說出一句臺詞
- 用於解說影片和廣告的簡短對話片段
- 讓一張人像照片說出你寫好的臺詞
daVinci-MagiHuman 真實範例
這裡的每張圖、每段影片都是用 daVinci-MagiHuman 生成的。按「做同款」會帶著同樣的提示詞和設定打開生成頁。
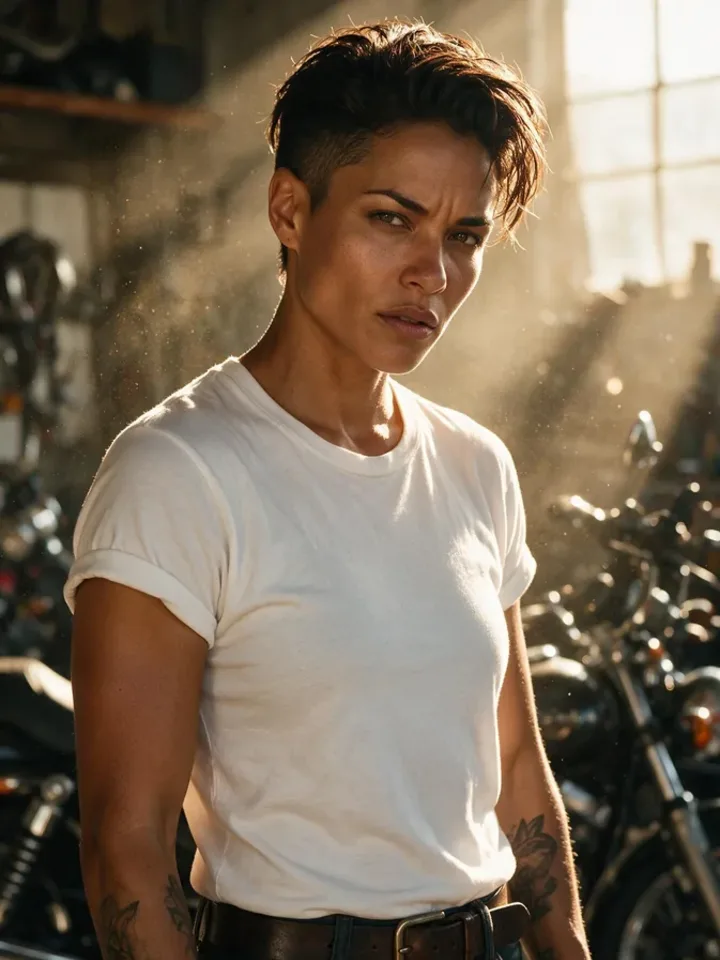 原圖
需要上傳你自己的圖片
daVinci-MagiHuman 能做什麼
每種模式都會在生成頁自動選好 daVinci-MagiHuman,生成前就能看到價格。
daVinci-MagiHuman 提示詞怎麼寫
- 引號中的臺詞要夠短,能在你選定的片段時長內從容說完。
- 需要保持臉部一致時,從照片開始;只用文字的話,每次都會生成一個新的人物。
- 先用 256p 草稿檢查節奏,再用 720p 或 1080p 渲染。
值得了解的設定
其餘設定都有合適的預設值,寫好提示詞就能直接生成。
resolution256p · 720p · 1080p- 輸出尺寸。越大越清晰,價格也越高。
aspect_ratio16:9 · 9:16- 畫面形狀:橫式、方形或直式。
duration_seconds5–10s- 影片長度,按秒計費。
image_url- 作為起點的那張圖。
seed0–2147483647- 用同一個數字,結果就能重現。
和同類怎麼選
做同一類事,各有所長,價格也不同。
MiniMax H3 是全能型影片模型,支援聲音,片段也更長。如果畫面主要是一個人在說話,就選 daVinci-MagiHuman。


關於 daVinci-MagiHuman 的常見問題
daVinci-MagiHuman 多少錢?
在 PopNow 上,daVinci-MagiHuman 最便宜的一次是 120 點(5 秒影片),約 US$0.12。尺寸越大越貴:256p 120 · 720p 240 · 1080p 360。用點數付費(1 點 = 0.001 美元),生成前按鈕上會顯示準確價格,生成失敗會自動退還點數。
daVinci-MagiHuman 能做什麼?
在 PopNow 上,daVinci-MagiHuman 支援這些模式:生成影片和圖生影片。在生成頁選好模式,寫提示詞或上傳素材即可。
daVinci-MagiHuman 的影片能多長、多清晰?
每段 5–10s,最高 1080p。
daVinci-MagiHuman 的提示詞怎麼寫?
引號中的臺詞要夠短,能在你選定的片段時長內從容說完。 需要保持臉部一致時,從照片開始;只用文字的話,每次都會生成一個新的人物。 先用 256p 草稿檢查節奏,再用 720p 或 1080p 渲染。
daVinci-MagiHuman 還是 MiniMax H3?
MiniMax H3 是全能型影片模型,支援聲音,片段也更長。如果畫面主要是一個人在說話,就選 daVinci-MagiHuman。
用 daVinci-MagiHuman 需要安裝什麼嗎?
不需要。daVinci-MagiHuman 在 PopNow 的網頁上直接使用:寫提示詞或上傳檔案,選好設定,下載結果。註冊後馬上就能生成。