
ComfyUI × PopNow
Modelos de IA na nuvem dentro do ComfyUI
Um pequeno nó personalizado coloca todos os modelos de imagem, vídeo e áudio da PopNow no seu grafo do ComfyUI. Sem GPU e sem baixar modelos: ele envia a tarefa, espera e entrega o resultado para o próximo nó.
- Prompt
- text
- Fashion editorial photograph in a…
- PopNow Generate
- model
- google/nano-banana-2.1/text-to-image
- options
- { }
- Preview Image
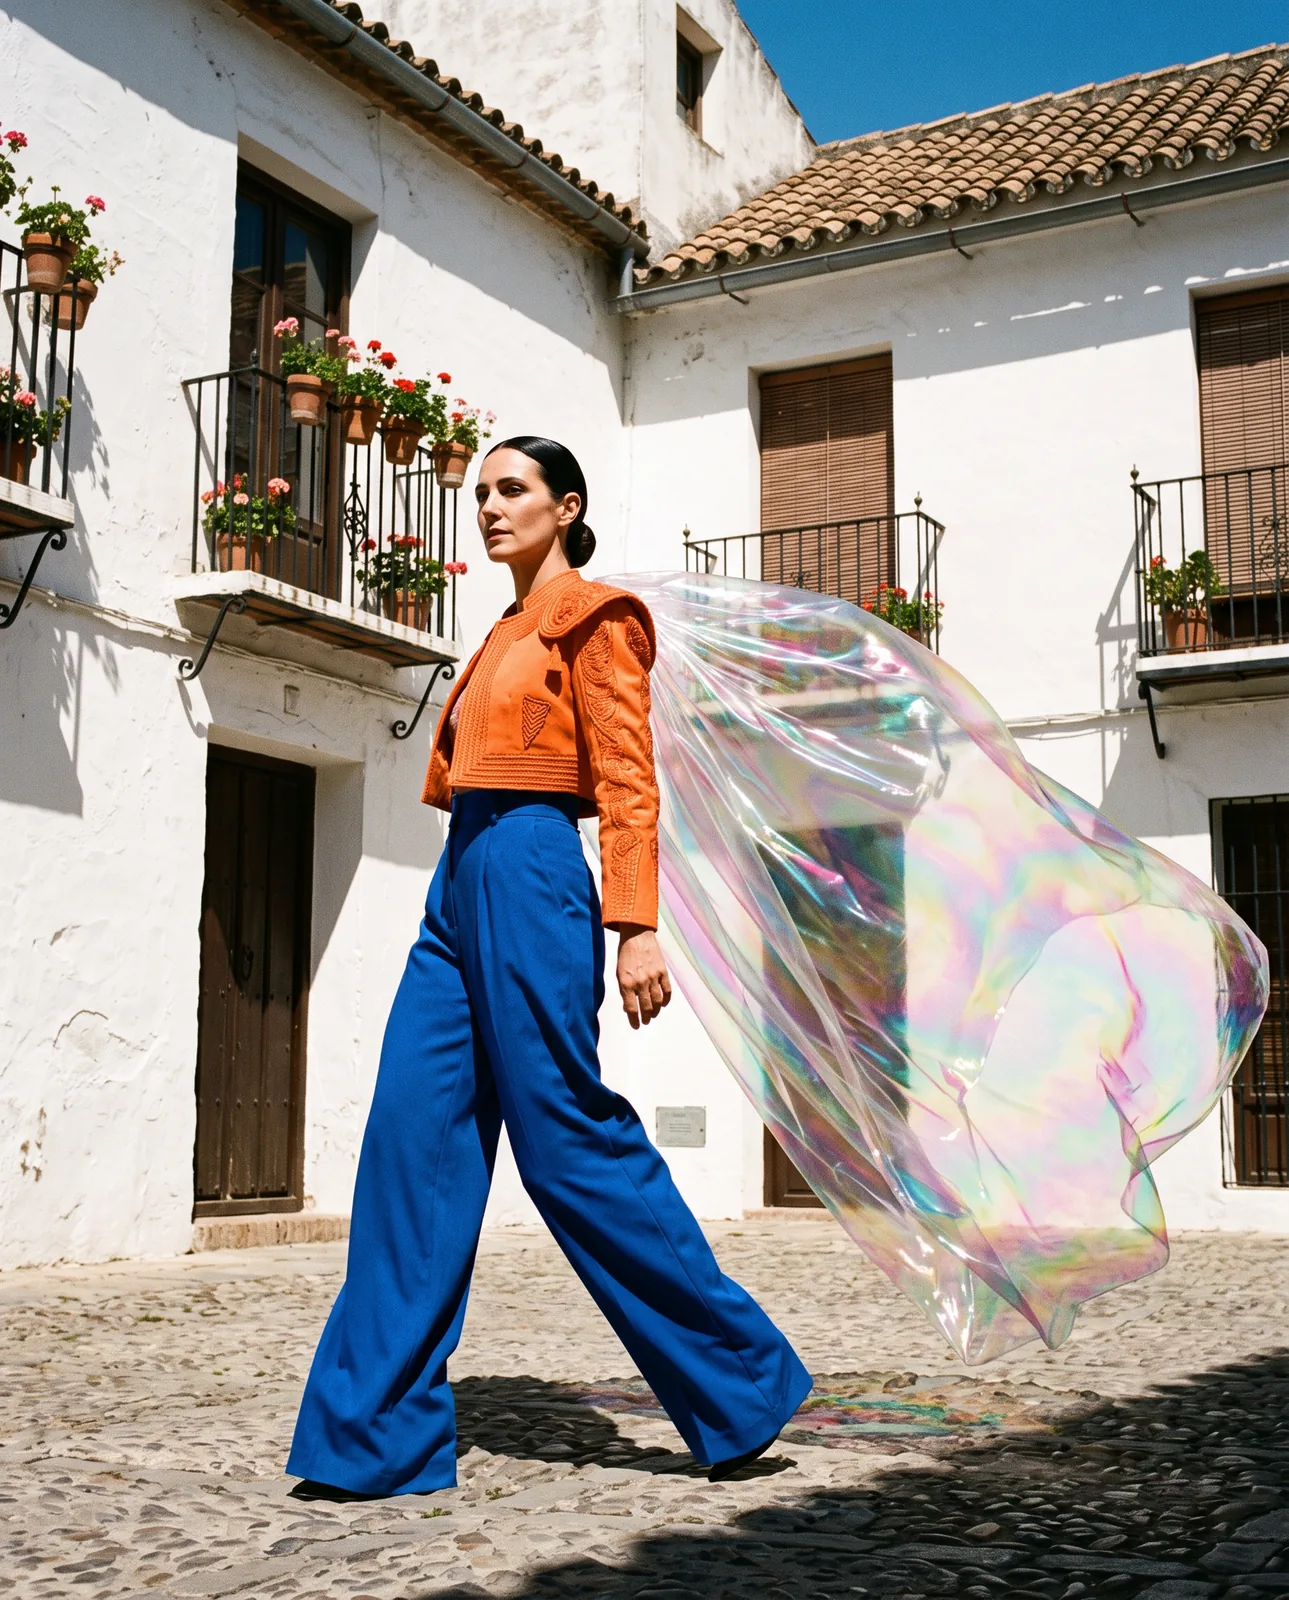
- Load Image
- PopNow Generate
- model
- bytedance/seedance-2.5/image-to-video
- image_field
- image_url
- Save Video
Instale em quatro passos
- Salve o código abaixo como custom_nodes/popnow_api.py dentro da pasta do ComfyUI.
- Defina POPNOW_API_KEY no ambiente de onde você abre o ComfyUI e reinicie o ComfyUI.
- Clique duas vezes no canvas, busque PopNow e adicione o nó PopNow Generate.
- Digite um nome de modelo e um prompt e coloque na fila. Imagens saem como IMAGE; vídeos e áudios são salvos na pasta output.
O nó
Python simples que usa só requests, Pillow, NumPy e PyTorch, que já vêm com o ComfyUI. Leia antes de rodar: ele é curto de propósito.
"""PopNow API node for ComfyUI.

Save as ComfyUI/custom_nodes/popnow_api.py, set POPNOW_API_KEY, restart ComfyUI.
Runs any PopNow image, video or audio model in the cloud and returns the result.
Docs: https://popnow.ai/docs
"""
import io
import json
import os
import time
import uuid

import numpy as np
import requests
import torch
from PIL import Image

import folder_paths

BASE = "https://api.popnow.ai/api/v1"
TERMINAL = ("succeeded", "failed", "canceled", "expired")


def _headers(extra=None):
    key = os.environ.get("POPNOW_API_KEY")
    if not key:
        raise RuntimeError("Set POPNOW_API_KEY before starting ComfyUI")
    return {"Authorization": f"Bearer {key}", **(extra or {})}


def _call(method, path, **kwargs):
    headers = _headers(kwargs.pop("headers", None))
    body = requests.request(method, BASE + path, headers=headers, timeout=60, **kwargs).json()
    if body.get("code") != 200:
        raise RuntimeError(f'PopNow {body.get("code")}: {body.get("msg")}')
    return body["data"]


def _upload(image):
    """IMAGE tensor -> PNG -> upload -> popnow:// reference."""
    arr = (image[0].cpu().numpy() * 255).clip(0, 255).astype(np.uint8)
    buf = io.BytesIO()
    Image.fromarray(arr).save(buf, format="PNG")
    data = buf.getvalue()
    ticket = _call("POST", "/common/upload-url", json={"contentType": "image/png", "bytes": len(data)})
    requests.put(ticket["uploadUrl"], data=data, headers=ticket.get("headers", {}), timeout=120).raise_for_status()
    return _call("POST", f'/files/{ticket["fileId"]}/commit')["uri"]


class PopNowGenerate:
    CATEGORY = "PopNow"
    RETURN_TYPES = ("IMAGE", "STRING", "STRING")
    RETURN_NAMES = ("image", "url", "path")
    FUNCTION = "run"

    @classmethod
    def INPUT_TYPES(cls):
        return {
            "required": {
                "model": ("STRING", {"default": "google/nano-banana-2.1/text-to-image"}),
                "prompt": ("STRING", {"multiline": True, "default": "A ceramic teapot on a linen cloth, soft window light, muted palette"}),
                "options": ("STRING", {"multiline": True, "default": "{\"aspect_ratio\":\"16:9\",\"resolution\":\"1k\",\"output_format\":\"png\"}"}),
            },
            "optional": {
                "image": ("IMAGE",),
                "image_field": ("STRING", {"default": "image_url"}),
            },
        }

    def run(self, model, prompt, options, image=None, image_field="image_url"):
        task_input = json.loads(options or "{}")
        if prompt.strip():
            task_input.setdefault("prompt", prompt)
        if image is not None:
            ref = _upload(image)
            task_input[image_field] = [ref] if image_field.endswith("s") else ref

        task_id = _call(
            "POST",
            "/jobs/createTask",
            headers={"Idempotency-Key": str(uuid.uuid4())},
            json={"model": model, "input": task_input},
        )["taskId"]

        delay = 2.0
        while True:
            time.sleep(delay)
            task = _call("GET", "/jobs/recordInfo", params={"taskId": task_id})
            assets = (task.get("output") or {}).get("assets") or []
            copying = any(a.get("pending") and not a.get("unavailable") for a in assets)
            if task["state"] in TERMINAL and not copying:
                break
            delay = min(delay * 1.5, 15.0)
        if task["state"] != "succeeded" or not assets:
            raise RuntimeError(f'PopNow {task["state"]}: {task.get("errorMessage", "no detail")}')

        asset = assets[0]
        content = requests.get(asset["url"], timeout=300).content
        mime = asset.get("mime", "")
        if mime.startswith("image/"):
            pil = Image.open(io.BytesIO(content)).convert("RGB")
            tensor = torch.from_numpy(np.asarray(pil).astype(np.float32) / 255.0)[None,]
            return (tensor, asset["url"], "")

        ext = {"video/mp4": ".mp4", "video/webm": ".webm", "audio/mpeg": ".mp3", "audio/wav": ".wav"}.get(mime, ".bin")
        path = os.path.join(folder_paths.get_output_directory(), f"popnow_{task_id}{ext}")
        with open(path, "wb") as f:
            f.write(content)
        # Video and audio: a small blank IMAGE keeps the graph valid; use the path output.
        return (torch.zeros((1, 64, 64, 3)), asset["url"], path)


NODE_CLASS_MAPPINGS = {"PopNowGenerate": PopNowGenerate}
NODE_DISPLAY_NAME_MAPPINGS = {"PopNowGenerate": "PopNow Generate"}
Entradas e saídas
model- Nome do modelo, por exemplo google/nano-banana-2.1/text-to-image. Toda página de API de modelo mostra ele.
prompt- O que você quer criar. Deixe vazio nos modelos que não usam prompt.
options- Outros campos em JSON, como resolution ou duration_seconds. A página de API do modelo lista todos.
image- Entrada IMAGE opcional. Ela é enviada para você e colocada no campo indicado em image_field.
image_field- Qual campo recebe a imagem: image_url na maioria dos modelos de vídeo, image_urls na edição de imagens.
image · url · path- IMAGE nos modelos de imagem, mais a URL do arquivo e o caminho local em vídeo e áudio.
Por que usar modelos na nuvem pelo ComfyUI
- Sem GPU
Modelos de vídeo que pedem 24 GB ou mais rodam do nosso lado. Seu notebook só envia o prompt.
- Combine com seus nós locais
Crie um quadro inicial localmente, anime com Kling ou Seedance e depois faça o upscale localmente de novo.
- Preço conhecido por geração
Todo modelo mostra os créditos antes, e gerações que falham são reembolsadas.
Bons modelos para começar




Perguntas sobre o ComfyUI
É um pacote oficial?
É um único arquivo que publicamos nesta página, não um pacote de registro. Copie, leia e atualize por aqui quando a API mudar.
Funciona no ComfyUI Desktop e no Comfy Cloud?
Funciona em qualquer lugar onde você consiga adicionar um nó personalizado e definir uma variável de ambiente: ComfyUI portátil, Desktop e servidores auto-hospedados.
Como pego os quadros do vídeo?
O nó salva o vídeo na pasta output do ComfyUI e devolve o caminho. Carregue com um nó de carregar vídeo para continuar trabalhando nos quadros.
Quanto custa uma geração?
Os mesmos créditos do site, mostrados na página de API de cada modelo. Enquanto testa, defina um limite diário para a chave no console.