自分の声を録音する必要はありますか?
ありません。「テキスト読み上げ」で原稿を書き、声を選んで、その結果を音声として使えます。

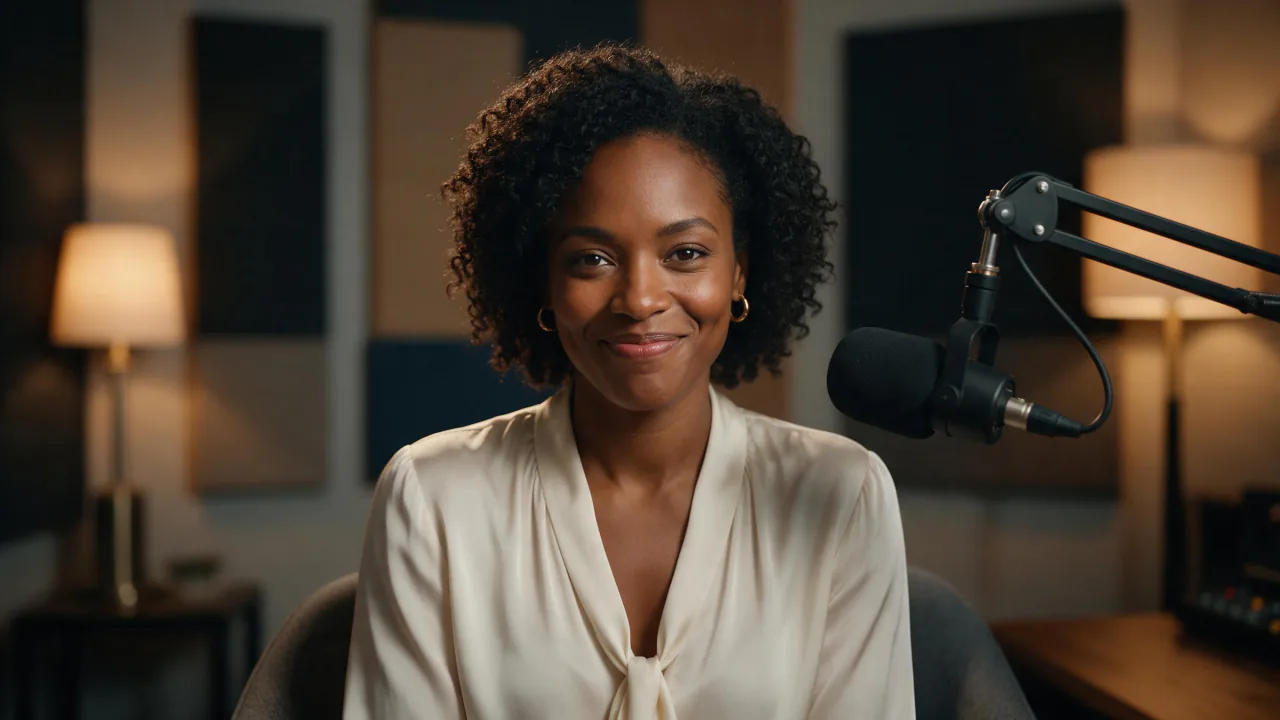
自分の録音を使うか、「テキスト読み上げ」で作りましょう。アバターモデルが唇を声に合わせ、自然なまばたきやうなずき、表情を加えるので、1枚の写真がプレゼンターになります。
 14クレジットから (動画5秒あたり)
 登録で30クレジット無料 · カード不要
 失敗した生成は自動で返却されます
 入れるもの
 できるもの料金
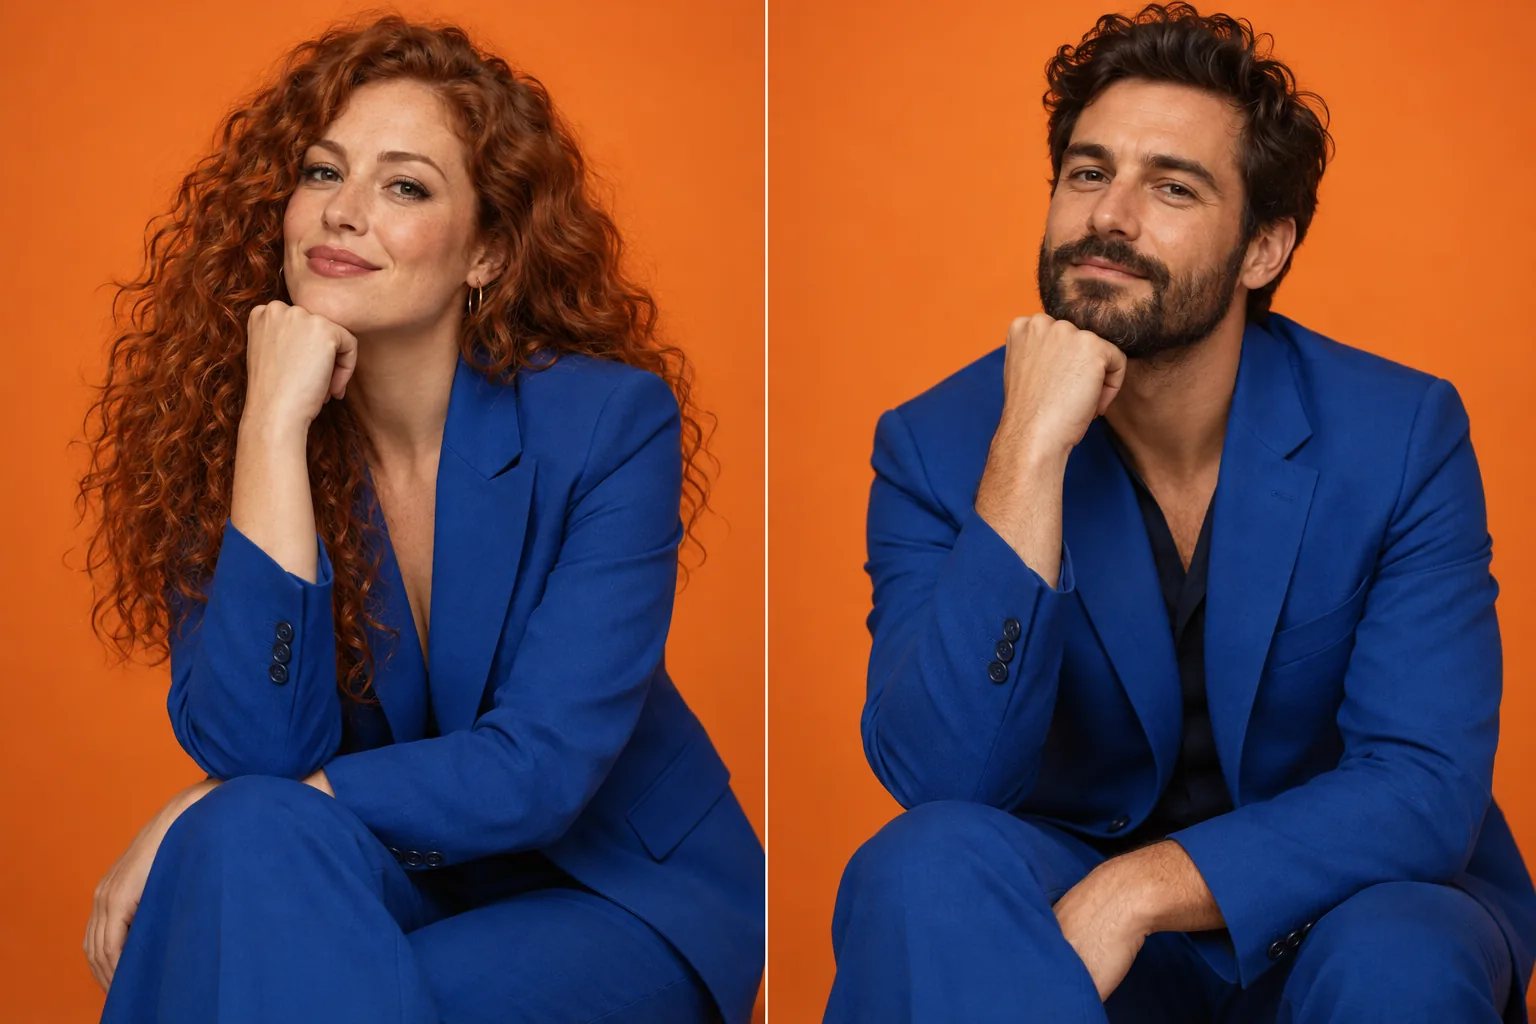
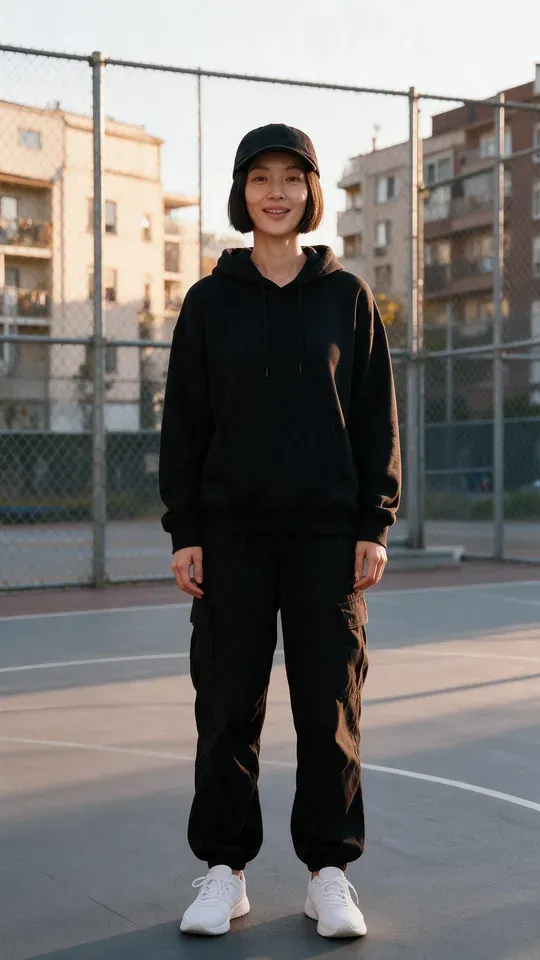
カメラのほうを向いた、はっきりしたポートレートをアップロードします。
音声を追加します:録音、または「テキスト読み上げ」で作ったナレーション。
生成します。動画の長さは音声と同じです。
最初はKling Avatar 2.0が選ばれています。ジェネレーターでいつでも別のモデルに切り替えられ、どれも実行前に料金が表示されます。
ありません。「テキスト読み上げ」で原稿を書き、声を選んで、その結果を音声として使えます。
各モデルの上限内で音声と同じ長さです。標準のアバターは最大1分、Kling Avatar 2.0は最大5分です。
「トーキングアバター」は静止画から始めて頭全体を動かします。「リップシンク」は動画から始めて口だけを変えます。
「トーキングアバター」は14クレジットから(動画5秒あたり)。実行前にジェネレーターで正確な料金が表示され、失敗した生成は自動で返却されます。新規アカウントには30クレジットが無料で付くので、それで試せます。
ファイルを入れて「生成」を押すだけ。結果はそのまま保存できます。登録でもらえる無料クレジットで最初の数回をまかなえます。