
你会得到
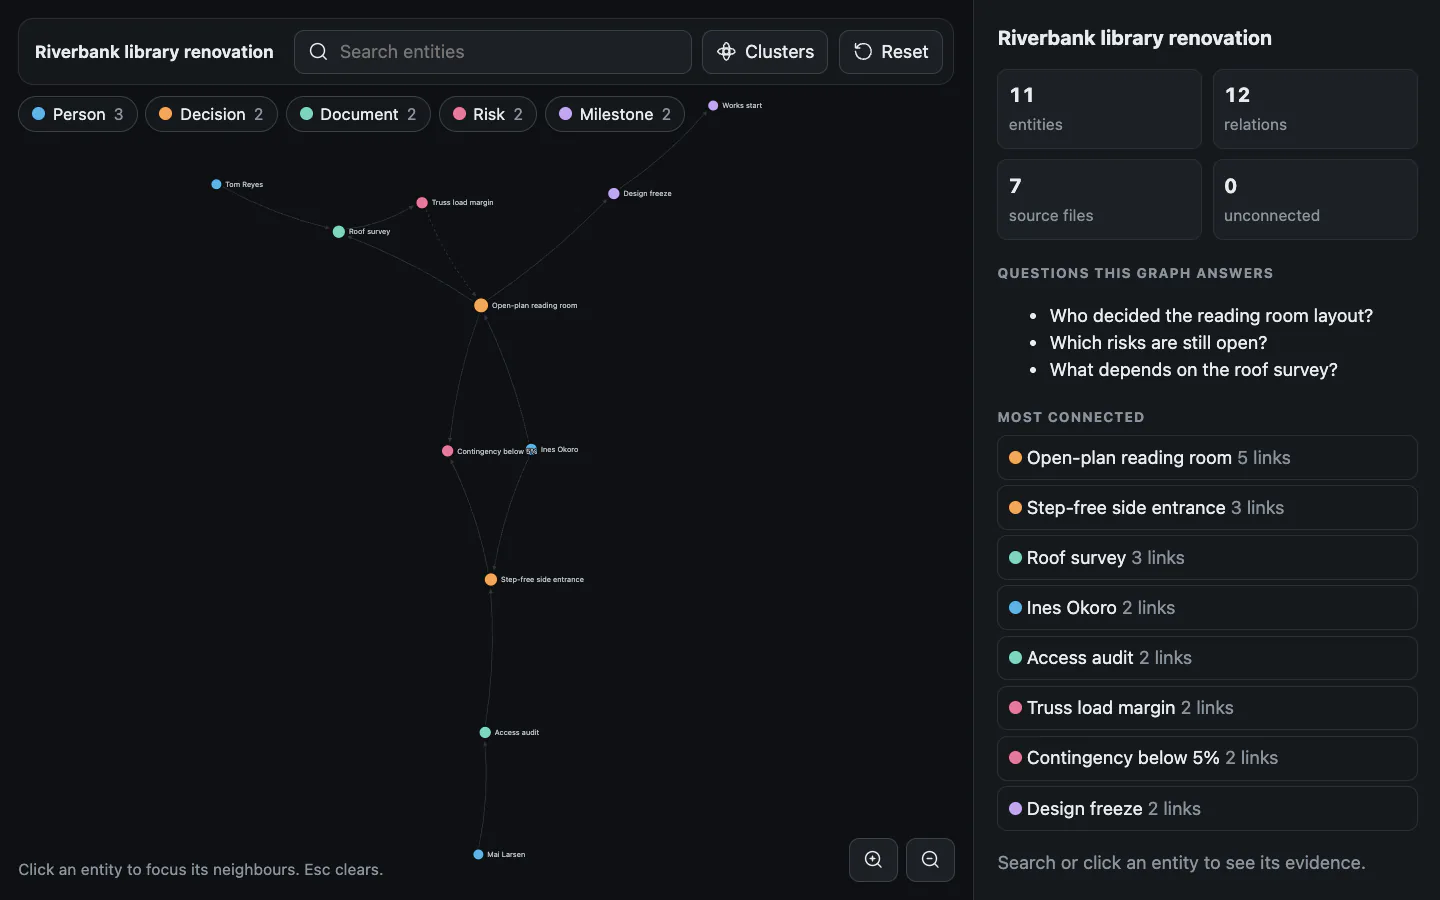
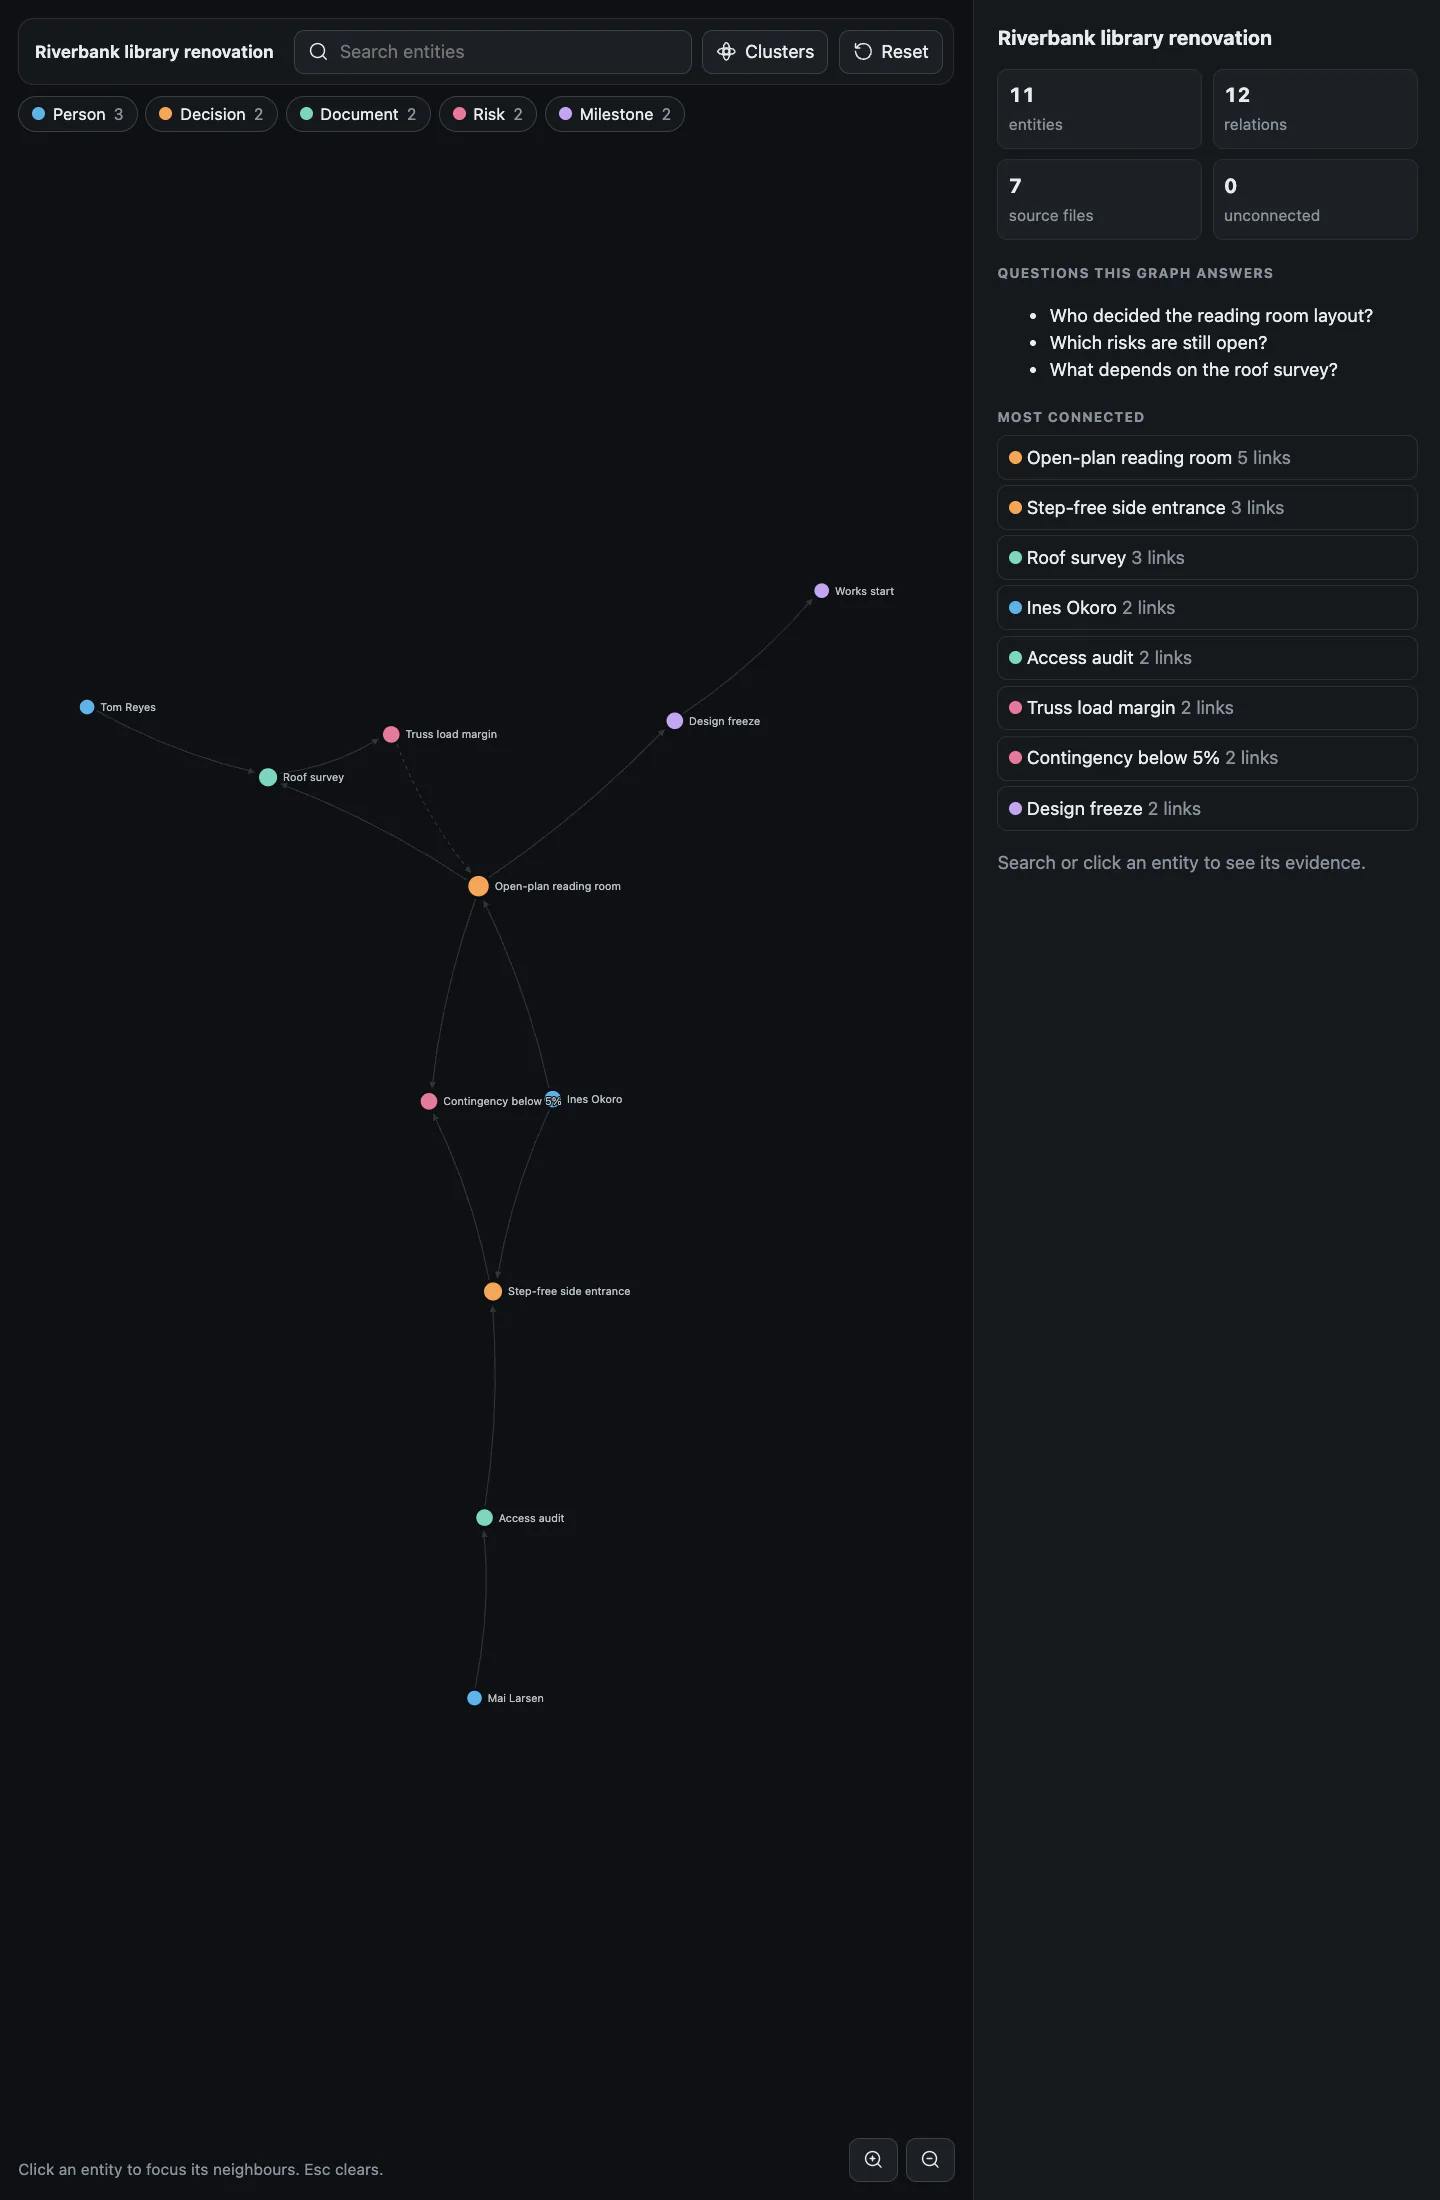
- 一个离线 HTML 图谱,支持搜索、类型筛选、聚焦和缩放
- 依据面板,每条结论都附文件、行号和引文
- JSON 数据集,已检查失效 ID 和缺失来源
- Markdown 文件夹扫描器,梳理笔记、链接和标签
- 可选:PopNow 生成的封面图,运行前先报价
适合
- 项目交接和新人上手资料包
- 研究笔记、Wiki 和决策日志
- 需要每条结论都可追溯的审计或尽调文件夹
不适合
- 每分钟都在变化的实时数据
- 需要总数、趋势或图表的问题
- 一个视图里放几千个实体
怎么用
在 Claude 或 ChatGPT 里
用 PopNow 的技能「知识图谱可视化」(knowledge-graph-explorer)帮我做这件事:梳理 ./handover 里的人员、决策和未解决的风险,让新负责人看清谁做了哪些决定、为什么这么定。
在编程 Agent 里
/popnow-knowledge-graph-explorer 梳理 ./handover 里的人员、决策和未解决的风险,让新负责人看清谁做了哪些决定、为什么这么定。
接着试试
加入供应商合同文件夹,并标出所有推断内容。
默认隐藏文档节点,再给我一份没有来源的结论清单。
需要准备
- 要纳入的文件夹或记录,以及要排除的内容
- 图谱应该回答的三个问题
- 实体类型和关系动词,或同意由技能来提议
类似技能
查看全部 →3D 头像制作工具
+3在浏览器里捏一个软萌毛绒风 3D 角色,保存为透明 PNG 或 3D 网页。
日历热力图
+3用带色阶的日历网格展示一整年的每日活动,附连续天数、总数和键盘操作。
AI SaaS 落地页
+3温暖的砂色纸面,发丝线的竖轨和斜线阴影围着一块实时看板,助手在上面规划任务。
动态 Hero 首屏区块
+3落地页首屏:标题中的一个词轻轻轮换,配两个按钮和一个宽幅图片框。
着色器主视觉的创意机构网站
+3一块实时的橙色热浪着色器主视觉,底部固定一句宣言,配胶囊导航和错落的案例网格。
深色 SaaS 落地页
+3深色、动效丰富的软件产品营销网站,交付为一个自包含的 HTML 文件。
设计师作品集网站
+3六张微微倾斜的卡片环绕着渐隐的标题,浅灰底色,一张红色人像卡片,以及编辑风格的案例研究。
程序员作品集网站
+3面向工程师的深色个人网站,含项目案例、文章、演讲、简历和联系表单。
编辑风 SaaS 网站
+3深蓝的分栏首屏,五行衬线标题配纪实照片,斜切的色带,以及一种钴蓝强调色。
玻璃拟态网站模板
+3近黑胶片上的磨砂玻璃胶囊,一行带斜体单词的超大衬线标题,以及邮箱订阅框。
硬件产品网站
+3银色影棚照片上是超大的细线型号名,磨砂规格卡片,按比例排列的产品阵列,以及硬件网格布局。
交互式系统架构图
+3离线可点击的系统架构图,基于经过校验的 JSON 模型生成,每个方框都附有依据。
互动网格主视觉
+3近黑底上的一张细线深色网格,会朝光标弯曲,并从每次点击中荡出一圈发光的波纹。
KPI 仪表盘模板
+3暖纸上的四个 KPI 方块,附变化标签,配发光折线图、分项表格和目标进度条。
AI 样稿转落地页
+3先看三张整页设计稿,选定一张,你的 Agent 再把它构建为干净、响应式的代码。
杂志网站模板
+3印刷级质感的杂志网站,含文章、专题、小型商店和订阅,整站就是一个 HTML 文件。
粒子动画主视觉
+3暖纸底色上的文案,旁边是一个旋转的墨色与青绿色圆点球体,按每个理念重组形状,并在滚动时散开。
个人品牌网站
+3一张羽化进暖纸的肖像,置于细线括号之下,两侧是轻重对比的陈述。
电影感产品发布页
+3电影光线下的近黑页面:衬线标题卡配漂移的光带,宽银幕式的夜景,以及预约表单。
后台管理系统模板
+3可直接运行的后台控制台,含图表、表格、看板和日历,整套就是一个离线 HTML 文件。
SaaS 落地页模板
+3沉静、明亮的软件产品营销网站,含可交互的产品控制台、定价和注册。
手帐风个人简历网站
+3用纸质物件拼成的多页在线简历,含项目案例和可打印的简历。
球鞋商城网站模板
+3完整的鞋履或服装网店,含商品目录、商品详情页、购物袋和演示结账,全在一个 HTML 文件里。
工作流自动化落地页
+3石墨灰页面,左对齐的小标题,下方是实时的节点图,会运行、重试并流式输出日志。
常见问题
实体和关联从哪里来?
来自你的文件。技能把它们当作文本读取,为每个实体和关系记录文件和行号,并标出哪些是推断出来而不是读到的。扫描器会自动处理 Markdown 链接和标签。
需要服务器或图数据库吗?
不需要。结果是一个内含数据的 HTML 文件,直接从本地打开,不发出任何网络请求。
图谱能有多大?
大约 150 个实体以内读起来很舒服,约 400 个以内仍然可用。更大的资料库会做摘要,或拆分成多个页面。
PopNow 在这个技能里做什么?
只在你确认价格后,为链接到图谱的页面生成一张可选的封面图或分享图。图谱本身始终根据你的数据构建。