什麼是 AI 數位人?
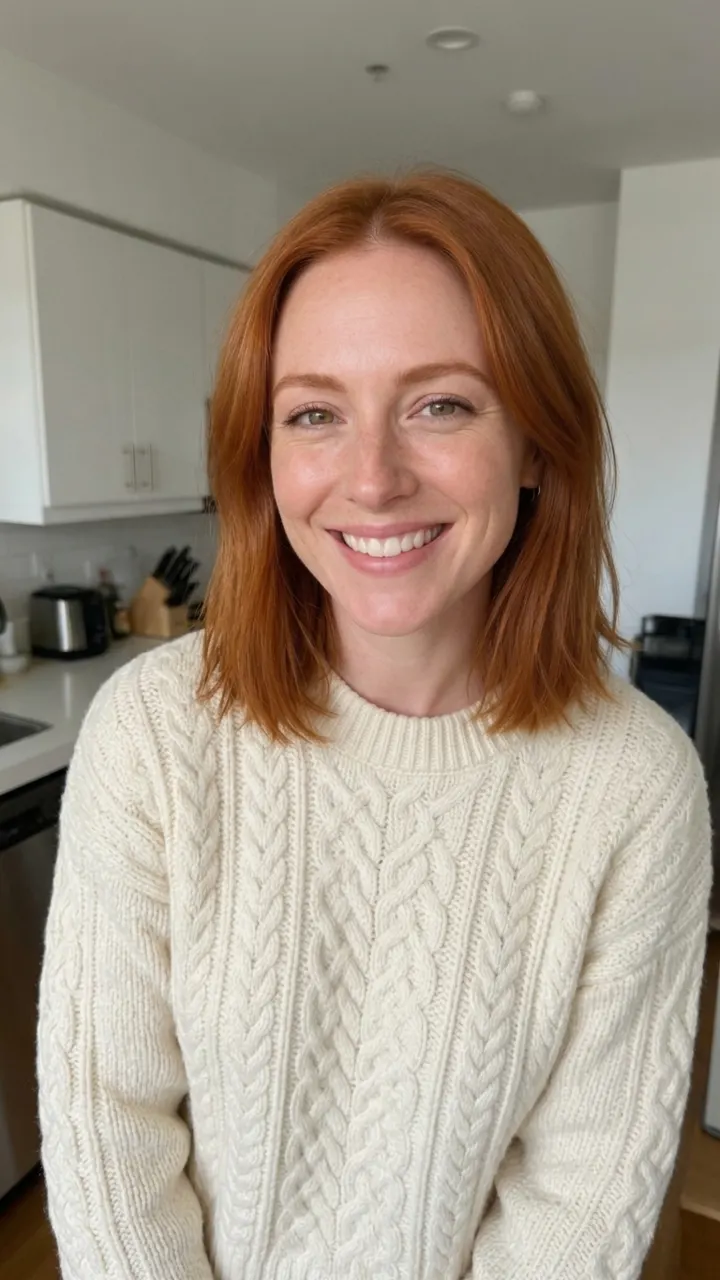
AI 數位人是由一張照片生成、看起來像真人在說話的影片。上傳人像,給它一段要說的話,臉部就會隨著語音動起來:嘴唇、眼睛、輕輕點頭和表情都會跟著聲音變化。
聲音來源由你決定。可以輸入文案,從六種錄音室聲音中選一種朗讀;也可以用你複製的聲音朗讀;還可以上傳錄音或歌曲。影片長度與音訊完全一致,從幾秒到一分鐘不等。
如何製作會說話的照片
- 新增人像一張清晰的照片,一張臉大致朝向鏡頭。半身照效果最好。
- 設定聲音輸入文案,選擇聲音或你複製的聲音,或上傳 3 到 60 秒的 MP3 或 WAV。
- 讓它開口開始前按鈕會顯示完整價格。下載影片,或傳送去剪輯、翻譯或分享。
為什麼在這裡製作數位人
- 支援任何語言。 文案會按你輸入的語言朗讀,同一張人像可以用英語、西班牙語或日語向顧客問好。
- 使用你自己的聲音。 複製一次你的聲音,之後做的每個數位人都能用它說話。
- 說話或唱歌。 上傳一首歌,人像就能演唱,呼吸和表情會跟著音樂變化。
- 選擇引擎。 自動模式會選擇快速、實惠的模型;需要更長的影片或 1080p 畫質時,可切換到進階數位人模型。
大家用它做什麼
- 店家問候 一張親切的臉,在商品頁或選單畫面上歡迎訪客。
- 課程與解說短片 同一位講師每次都來講解的短課。
- 生日祝福 用你的聲音,讓照片裡的人送上生日祝福。
- 社群貼文 不必架設攝影機,就能做開場和結尾的說話片段。
讓效果更自然的技巧
- 使用清晰、光線均勻的照片。墨鏡、手遮住嘴、側臉角度大,都會讓嘴型更難跟上。
- 每段影片控制在一分鐘以內,長文案可以拆成多個場景。
- 標點會影響朗讀節奏:逗號帶來短暫停頓,驚嘆號讓語氣更有力。
- 唱歌時,上傳乾淨的人聲軌。樂器過重會讓嘴型變得模糊。
請負責任地使用
只使用你本人的臉和聲音,或已同意的人的臉和聲音。請勿上傳任何未滿 18 歲的人的素材,也不要用結果誤導他人,讓人以為某人說過或做過某件事。每個請求都會經過 PopNow 的內容審核,上傳的素材僅用於生成你的結果。
價格
依成片秒數計費:Talking Avatar 每秒消耗 18 點,因此輸入文案的 10 秒片段,連同聲音約需 184 點。開始前按鈕總會顯示總價,失敗的任務會退還點數。
常見問題
可以使用任何照片嗎?+
請使用你本人或已同意的人的照片,切勿使用未滿 18 歲的人的照片。上傳的照片在使用前需要勾選一次許可確認。
它能說哪些語言?+
輸入的文案會按你書寫的語言朗讀,包括英語、西班牙語、法語、德語、葡萄牙語、日語、韓語和中文。上傳的音訊可以是任何語言。
影片最長多久?+
預設模型支援 3 到 60 秒;「更多選項」中的進階模型可接受更長的音訊。
它能唱歌嗎?+
可以。選擇「上傳音訊」並新增一首歌,人像會演唱到音軌結束為止。
費用是多少?+
Talking Avatar 每秒影片消耗 18 點,因此含聲音的 10 秒片段約需 184 點。
影片歸誰所有?+
歸你所有。結果會儲存到你的 PopNow 資料庫,只要你對照片和聲音擁有相應權利,即可商用。
 範例