di Sand.aiVideo
daVinci-MagiHuman
Metti una battuta tra virgolette e la persona in scena la pronuncia
- Fino a 1080p
- Clip da 5 a 10 s
Da 120 crediti per una clip di 5 secondi≈ 0,12 USD· Crea video
Com'è usarlo
daVinci-MagiHuman, un modello aperto di Sand.ai e SII-GAIR, genera insieme immagine e voce: metti una battuta parlata tra virgolette e la persona in scena la dice. Crea clip da 5 a 10 secondi a partire da un prompt o da una foto di partenza, in 256p, 720p o 1080p, in 16:9 o 9:16.
Ideale per
- Un presentatore che dice una battuta rivolgendosi alla camera
- Brevi momenti di dialogo per spiegazioni e pubblicità
- Animare un ritratto che pronuncia una battuta che scrivi tu
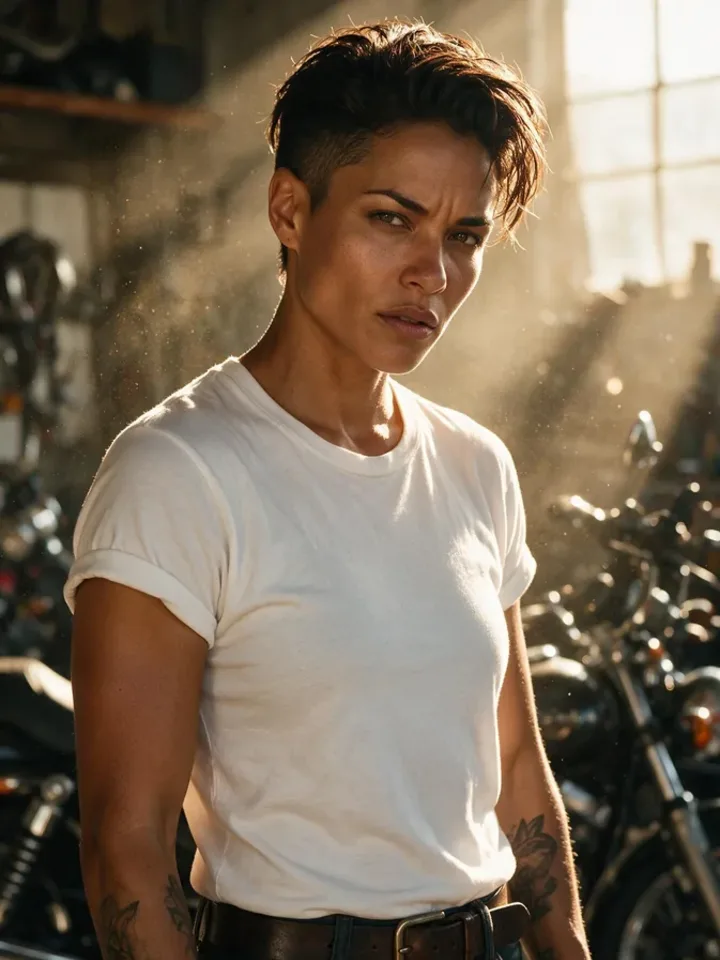
Risultati reali di daVinci-MagiHuman
Ogni immagine e clip qui è stata generata con daVinci-MagiHuman. Premi Rifai per aprirla nello studio con lo stesso prompt e le stesse impostazioni.
 Originale
Usa una tua immagine
Cosa sa fare daVinci-MagiHuman
Ogni modalità si apre nello studio con daVinci-MagiHuman già selezionato. Il prezzo compare prima di generare.
Come scrivere i prompt per daVinci-MagiHuman
- Tieni la battuta tra virgolette abbastanza breve da poterla dire comodamente nella durata che scegli.
- Parti da una foto quando il volto deve restare lo stesso; il solo testo inventa ogni volta una persona nuova.
- Fai una bozza in 256p per controllare i tempi, poi genera in 720p o 1080p.
Impostazioni da conoscere
Tutto il resto ha valori predefiniti sensati: scrivi un prompt e vai.
resolution256p · 720p · 1080p- Dimensione dell'output. Più grande è più nitido e costa di più.
aspect_ratio16:9 · 9:16- La forma dell'inquadratura: larga, quadrata o verticale.
duration_seconds5–10s- Quanto dura la clip. Si paga al secondo.
image_url- L'immagine di partenza.
seed0–2147483647- Lo stesso numero dà un risultato ripetibile.
Il confronto
Lo stesso tipo di lavoro, con punti di forza e prezzi diversi.
MiniMax H3 è il modello video polivalente con audio e clip più lunghe. Scegli daVinci-MagiHuman quando la scena è per lo più una persona che parla.


Domande su daVinci-MagiHuman
Quanto costa daVinci-MagiHuman?
Su PopNow, la generazione più economica con daVinci-MagiHuman costa 120 crediti (0,12 USD) per una clip di 5 secondi. I formati più grandi costano di più: 256p 120 · 720p 240 · 1080p 360. Paghi con i crediti (1 credito = 0,001 $), il costo esatto compare sul pulsante Genera prima di iniziare e le generazioni non riuscite vengono rimborsate automaticamente.
Cosa sa fare daVinci-MagiHuman?
Su PopNow, daVinci-MagiHuman funziona in queste modalità: Crea video e Da immagine a video. Scegline una nello studio e aggiungi un prompt o un file.
Quanto durano e quanto sono nitidi i video di daVinci-MagiHuman?
Le clip durano 5–10s, fino a 1080p.
Come si scrivono i prompt per daVinci-MagiHuman?
Tieni la battuta tra virgolette abbastanza breve da poterla dire comodamente nella durata che scegli. Parti da una foto quando il volto deve restare lo stesso; il solo testo inventa ogni volta una persona nuova. Fai una bozza in 256p per controllare i tempi, poi genera in 720p o 1080p.
daVinci-MagiHuman o MiniMax H3?
MiniMax H3 è il modello video polivalente con audio e clip più lunghe. Scegli daVinci-MagiHuman quando la scena è per lo più una persona che parla.
Devo installare qualcosa per usare daVinci-MagiHuman?
No. daVinci-MagiHuman funziona nel browser su PopNow: scrivi un prompt o aggiungi un file, scegli le impostazioni e scarica il risultato. Dopo la registrazione puoi generare subito.
Crea qualcosa con daVinci-MagiHuman
Scrivi un'idea, scegli le impostazioni e vedi il prezzo prima di premere Genera.