de Sand.aiVídeo
daVinci-MagiHuman
Pon una frase entre comillas y la persona de la pantalla la dice
- Hasta 1080p
- Clips de 5 a 10 s
Desde 120 créditos por un clip de 5 segundos≈ 0,12 US$· Crear video
Cómo es usarlo
daVinci-MagiHuman, un modelo abierto de Sand.ai y SII-GAIR, genera la imagen y la voz a la vez: pon una frase hablada entre comillas y la persona en pantalla la dice. Crea clips de 5 a 10 segundos a partir de un prompt o de una foto inicial, en 256p, 720p o 1080p, en 16:9 o 9:16.
Ideal para
- Un presentador que dice una frase directamente a cámara
- Momentos cortos de diálogo para explicadores y anuncios
- Animar un retrato que pronuncia una frase que tú escribes
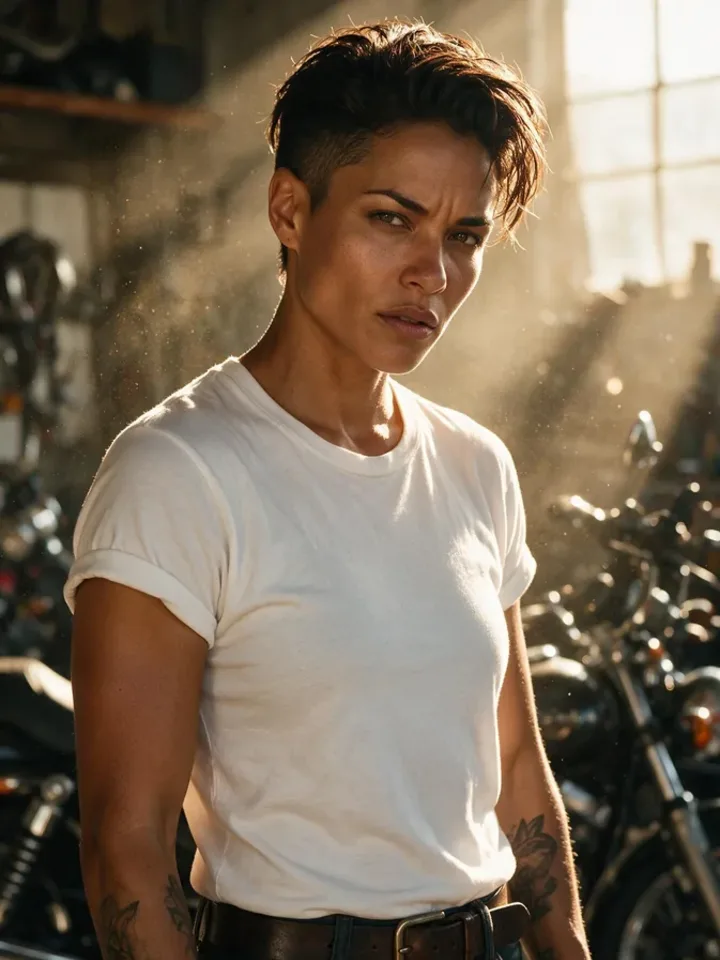
Resultados reales de daVinci-MagiHuman
Cada imagen y cada clip de aquí se generó con daVinci-MagiHuman. Pulsa Repetir para abrirlo en el estudio con el mismo prompt y los mismos ajustes.
 Original
Usa tu propia imagen
Qué puede hacer daVinci-MagiHuman
Cada modo se abre en el estudio con daVinci-MagiHuman ya seleccionado. El precio aparece antes de generar.
Cómo escribir prompts para daVinci-MagiHuman
- Mantén la frase entre comillas lo bastante corta para decirla cómodamente en la duración del clip que elijas.
- Parte de una foto cuando el rostro deba mantenerse igual; el texto solo inventa una persona nueva cada vez.
- Haz un borrador en 256p para comprobar el ritmo y luego renderiza en 720p o 1080p.
Ajustes que conviene conocer
Todo lo demás tiene un valor por defecto sensato, así que escribe un prompt y listo.
resolution256p · 720p · 1080p- Tamaño de salida. Más grande es más nítido y cuesta más.
aspect_ratio16:9 · 9:16- La forma del encuadre: horizontal, cuadrado o vertical.
duration_seconds5–10s- Cuánto dura el clip. Se cobra por segundo.
image_url- La imagen de partida.
seed0–2147483647- Repite el mismo número para obtener un resultado reproducible.
Cómo se compara
El mismo tipo de trabajo, con otros puntos fuertes y otros precios.
MiniMax H3 es el modelo de video polivalente, con sonido y clips más largos. Elige daVinci-MagiHuman cuando la escena sea sobre todo una persona hablando.


Preguntas sobre daVinci-MagiHuman
¿Cuánto cuesta daVinci-MagiHuman?
En PopNow, la generación más barata con daVinci-MagiHuman cuesta 120 créditos (0,12 US$) por un clip de 5 segundos. Los tamaños mayores cuestan más: 256p 120 · 720p 240 · 1080p 360. Pagas con créditos (1 crédito = 0,001 $), el coste exacto aparece en el botón Generar antes de empezar y las generaciones fallidas se reembolsan automáticamente.
¿Qué puede hacer daVinci-MagiHuman?
En PopNow, daVinci-MagiHuman funciona en estos modos: Crear video e Imagen a video. Elige uno en el estudio y añade un prompt o un archivo.
¿Cuánto duran y qué nitidez tienen los vídeos de daVinci-MagiHuman?
Los clips duran 5–10s, hasta 1080p.
¿Cómo escribo prompts para daVinci-MagiHuman?
Mantén la frase entre comillas lo bastante corta para decirla cómodamente en la duración del clip que elijas. Parte de una foto cuando el rostro deba mantenerse igual; el texto solo inventa una persona nueva cada vez. Haz un borrador en 256p para comprobar el ritmo y luego renderiza en 720p o 1080p.
¿daVinci-MagiHuman o MiniMax H3?
MiniMax H3 es el modelo de video polivalente, con sonido y clips más largos. Elige daVinci-MagiHuman cuando la escena sea sobre todo una persona hablando.
¿Tengo que instalar algo para usar daVinci-MagiHuman?
No. daVinci-MagiHuman funciona en tu navegador en PopNow: escribe un prompt o añade un archivo, elige los ajustes y descarga el resultado. Al registrarte puedes generar al momento.
Crea algo con daVinci-MagiHuman
Escribe una idea, elige los ajustes y mira el precio antes de pulsar Generar.